
VASP MLFF在线补点与固定测试集复测
从已有标签继续20步在线学习,区分DFT调用与ML预测,新增10个真实标签后再次比较相同测试集。
阅读本篇目录
下载VASP MLFF重拟合、补点与短轨迹完整示例,保存为example.zip:
python3 -m zipfile -e example.zip .
cd vasp-mlff-active-examples
bash results.sh
bash plot.sh
这几步读取参考数据并绘图,不启动新的VASP计算。完整输入在inputs/,原生结果在reference-results/,两个自有模型在models/,数值标签与七份CSV在data/。自己运行时,在本目录准备与标签一致的合法PBE64 Si POTCAR,再提交sbatch run.slurm。附件不含POTCAR、WAVECAR或VASP程序。
本例VASP6.6.1 GPU入口使用NVHPC25.3、CUDA12.8、HPC-X2.22.1、MKL2023.2;实际选择/重拟合/测试/末端DFT在P100,在线学习在V100 16G,每次1MPI进程、1CPU线程、1GPU。附带单作业模板选择P100,串起各阶段。
1. 从已有数据库继续学习#
把select输出的ML_ABN复制为新目录的ML_AB,当前结构采用一个新的随机扰动Si16起点,位移标准差0.065Å、固定种子20261112。它不是那6个测试构型之一。
本例从这一新起点运行600K、1fs步长的20步在线学习。完整INCAR:
SYSTEM = si-thermal-static
ENCUT = 550
PREC = Accurate
EDIFF = 1E-6
NSW = 20
IBRION = 0
ISMEAR = 0
SIGMA = 0.05
ISYM = 0
LREAL = .FALSE.
LASPH = .TRUE.
LWAVE = .FALSE.
LCHARG = .FALSE.
NELM = 150
ALGO = Normal
NBANDS = 48

ISTART = 0
ICHARG = 2
ML_LMLFF = .TRUE.
ML_MODE = train
ML_CTIFOR = .005
ML_MB = 256
ML_MCONF = 128
ML_MCONF_NEW = 8
TEBEG = 600
TEEND = 600
POTIM = 1
MDALGO = 2
SMASS = 0

ML_ICRITERIA = 0
ML_CDOUB = 1.0
ML_NMDINT = 1
RANDOM_SEED = 77123 0 0
ISIF = 2
起点完整POSCAR:
Si
 1.0000000000000000
     0.0000000000000000    5.4689259125969842    5.4689259125969842
     5.4689259125969842    0.0000000000000000    5.4689259125969842
     5.4689259125969842    5.4689259125969842    0.0000000000000000
 Si
  16
Cartesian
  0.0890563268253624 -0.0859792808579652 -0.0086760413060598
 -0.0859176380230253  2.6202571990480874  2.8213194657801934
  2.7117414210923272 -0.0030967227306517  2.7974019575115427
  2.8330614417255018  2.7536463246440559  5.5153310258785293
  2.7137546077565728  2.7453159115435439  0.0294718494557969
  2.7764755969077428  5.4830838693325372  2.7309149925639873
  5.3836888825840283  2.7233914296634083  2.7169507441881446
  5.4598749682554253  5.5714813747206993  5.4513162889342306
  1.4770609284659275  1.3024421051572963  1.4660221019380051
  1.3105388076620113  4.0956043022729123  4.1229768806907732
  4.1615821506211148  1.3817976336266982  4.1007442002732368
  4.1019566042676168  4.1001077245922986  6.8670722456993065
  4.1044564847490541  4.1103302577048400  1.3729576253487767
  4.0655235073822160  6.8943055109506632  4.1386979447450081
  6.8793612262465027  4.1147729848325865  4.1213005364758031
  6.9322340236226418  6.7856149115328668  6.8406368670238464
晶胞固定、KPOINTS仍为4×4×4Gamma。在线学习应明确设置ISIF=2,因为构建标签需要应力;MD默认ISIF=0不能满足这个要求。ISIF=2计算应力但不让晶胞自由变化。
ML_CTIFOR=0.005控制此例的学习阈值,不是结构优化的力收敛标准;ML_ICRITERIA=0固定判据。不同模型不应机械照搬这个数值,先观察实际误差估计与调用频率。
2. 任务中哪些步真的调用DFT#
完整脚本run.py依次处理已有数据、在线学习和后续复测;提交:
sbatch run.slurm
查看原生日志:
sed -n '/^STATUS/p' reference-results/active-stress/ML_LOGFILE
cat data/active-learning-steps.csv
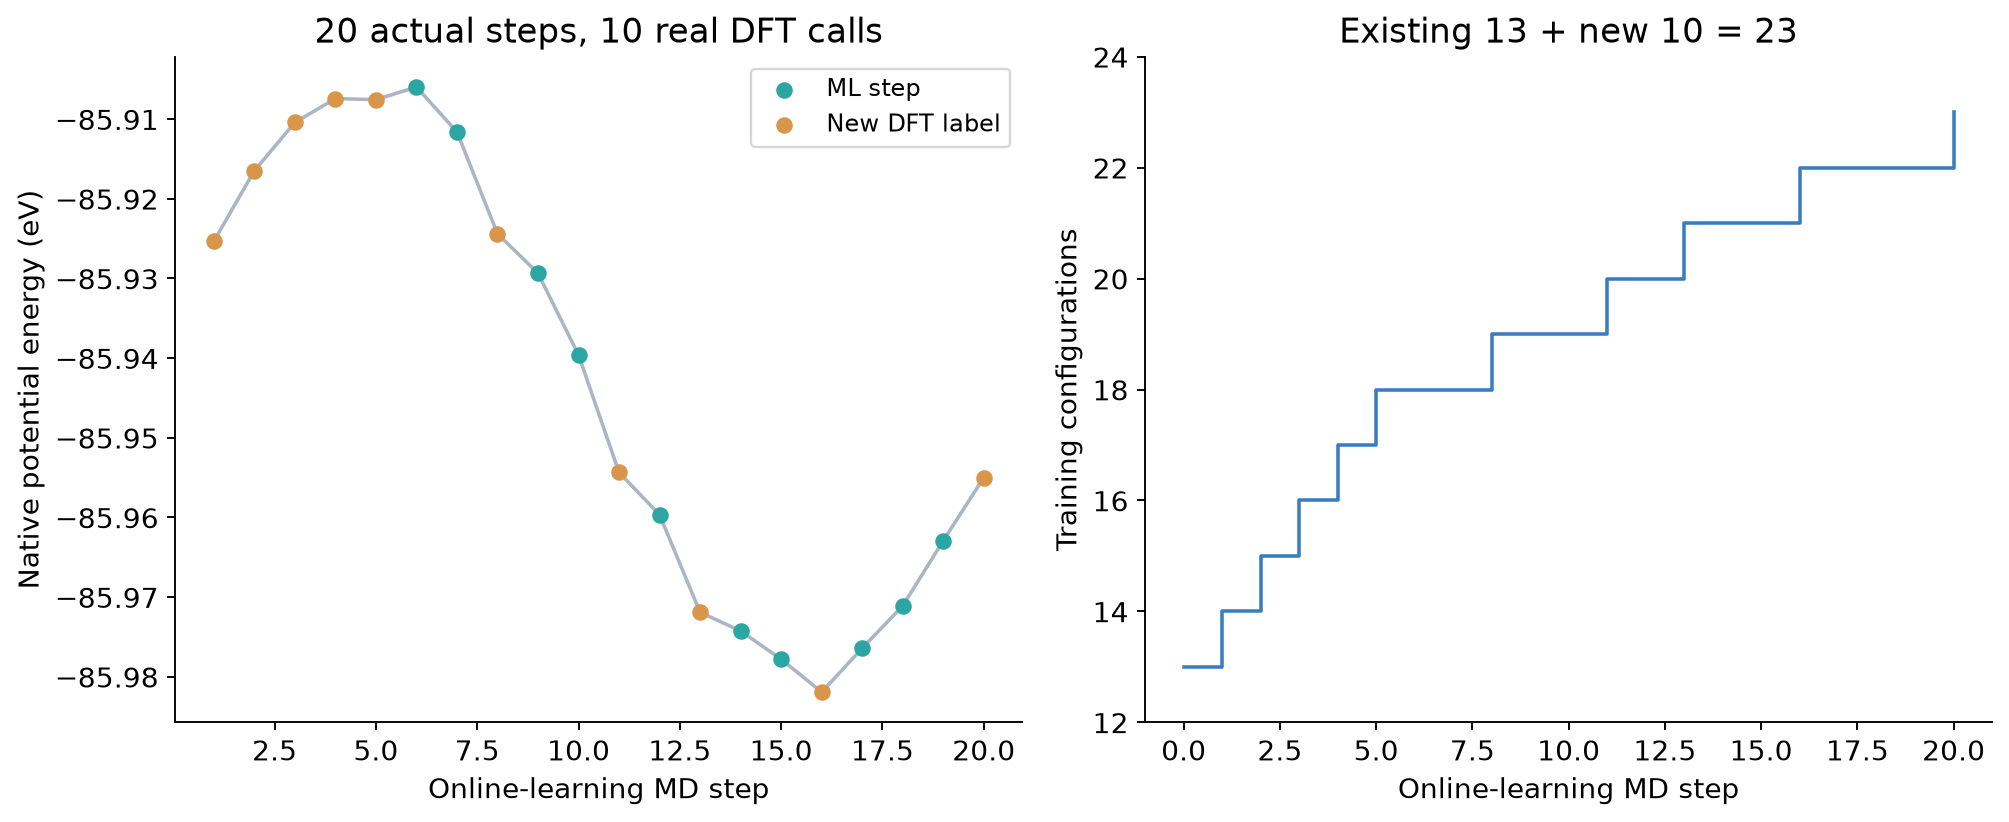
本次20步有10次真实DFT标注,其他步使用ML;训练库从13个增至23个。可以从STATUS的DFT标志与ML_ABN构型数同时确认。
不要按OUTCAR中TOTEN出现了多少次来数标注:电子迭代会反复打印能量,同一步也可能先打印ML预测,再由DFT纠正。本例的源OUTCAR有大量中间能量行,实际新增的标签仍然只有10个。
3. 重新拟合后,仍用同一组测试点#
在线学习结束后,将新的ML_ABN传给refit-after,生成新模型,再使用与初始模型完全相同的6个测试POSCAR。没有把测试构型加入训练库,也没有为了改善表格重新选择测试点。
cat data/frozen-heldout-tests.csv
| 指标 | 13标签模型 | 23标签模型 |
|---|---|---|
| 能量RMSE / meV·atom⁻¹ | 0.1314 | 0.08049 |
| 力分量RMSE / eV·Å⁻¹ | 0.01143 | 0.007929 |
本次新增标签改善了这组小测试的误差,不代表对所有结构都会改善,更不代表训练覆盖已经充分。重复运行时,轨迹与触发DFT的数量可能随程序和硬件有细微变化;应读取自己的日志,不能强求每次恰好10次。
4. 文件最后怎么保留#
ls models/before/ML_FF models/after/ML_FF
资料包保留两个实际模型与各自来源,便于比较。自己完成的模型在work/refit-before/ML_FFN和work/refit-after/ML_FFN;在线训练数据库是work/active-stress/ML_ABN。
继续学习应传递训练数据库,纯预测应传递模型,两者用途不同。模型固定后再做短轨迹与DFT抽查,不要一边偷偷补测试点、一边把结果称为独立预测。