
CP2K GPU显存怎么估:实际采样与模型边界
给出PBE32和三水HF的逐设备显存采样,解释基组、网格、MPI上下文与多卡分布对占用的影响。
阅读本篇目录
CP2K显存不能只按原子数估算。基组决定矩阵维度,晶胞与网格参数决定密度网格,精确交换和求解器又有独立工作区。先看相同输入的实际采样,再讨论自己的模型。
1. 读取真实采样#
下载CP2K GPU输入、实际输出、CSV与绘图资料包,保存为example.zip:
python3 -m zipfile -e example.zip .
cd cp2k-gpu-practical-data
bash results.sh
bash read.sh
bash plot.sh
资料来自2026年10月22日实际Slurm计算;本次复用结果,不重新跑性能任务。data/是逐次数据,reference-results/保存原生输出,figures/为可重画图片。
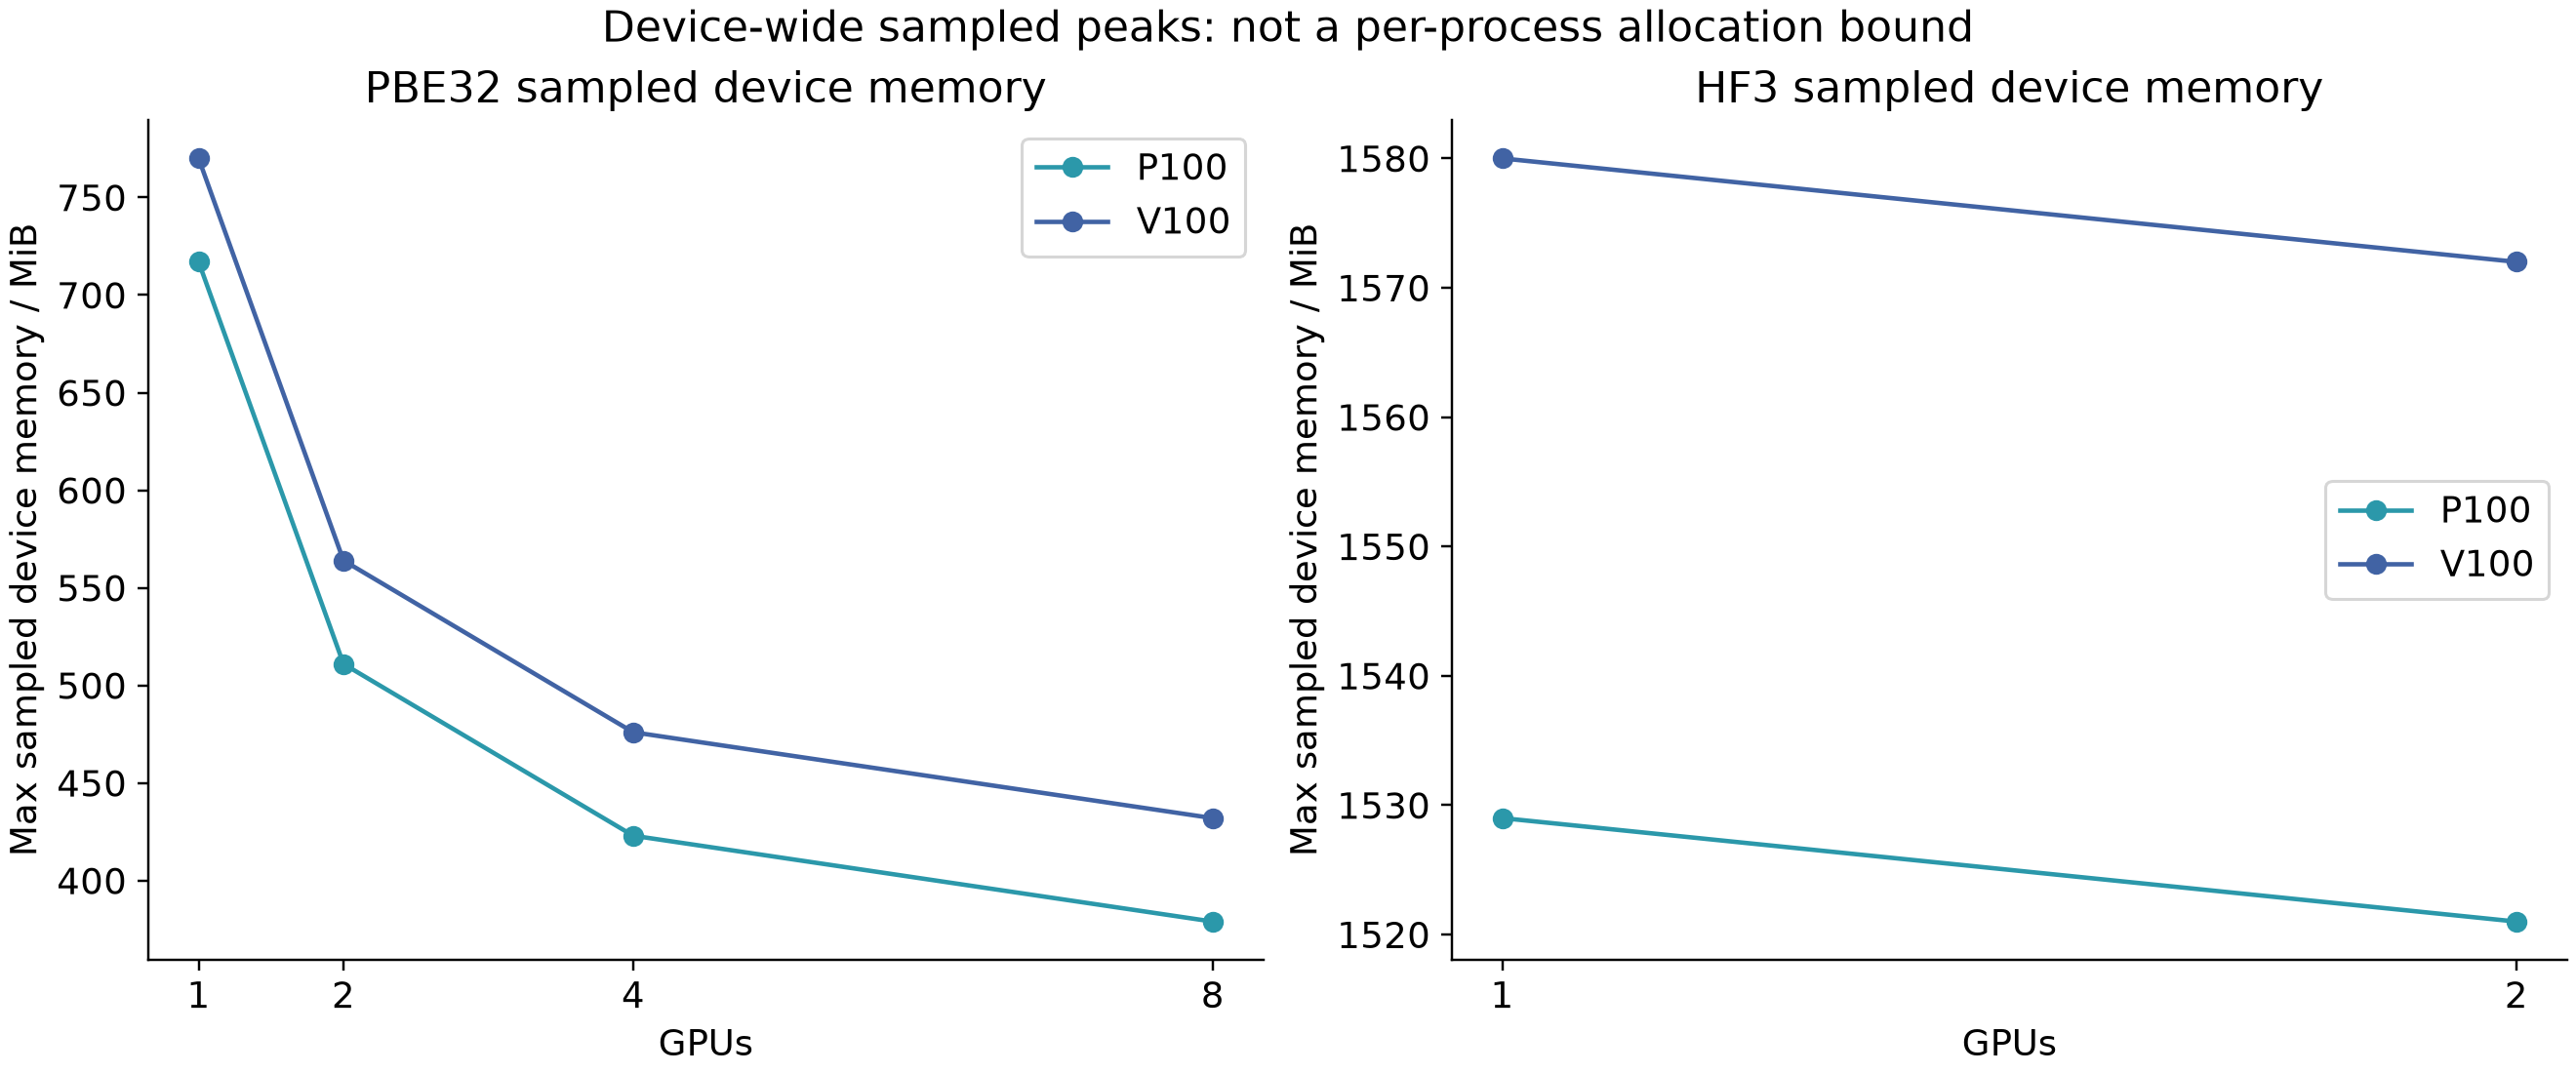
原测试每约250 ms查询GPU设备,表中的值是正式运行中可见设备的最大采样占用,单位MiB。它是设备层面的采样值,含上下文及设备基线,不是CP2K独占显存的精确分配上限,也可能漏掉短暂峰值。
head reference-results/p100/pbe32-1g-r1/gpu.csv
cat data/CP2K-GPU-timing-memory-summary.csv
本例PBE32从单卡到多卡,单设备最大采样值下降;但三水HF单/双卡都约1.5 GiB上下,说明不是所有数据都会随卡数均分。这两个小模型不足以建立任意原子数到显存的容量曲线。
2. 自己运行时怎么观察#
先在新解压目录选择与账号资源相符的提交脚本,例如P100单卡或V100 16GB单卡:
sbatch p100-pbe32-1g.slurm
或:
sbatch v100-pbe32-1g.slurm
这是核时GPU分区的示例脚本。套餐账号应使用yskit中对应账号、平台的CP2K模板,并保持本例MPI/OMP与GPU申请匹配。每个作业只跑一个配置,先预热一次,再正式运行三次;不会自动提交全部配置。新结果可以这样读取:
python3 read-one.py work/p100-pbe32-1g/r1
完整历史比较仍用bash read.sh。不要把Slurm脚本直接改成在登录节点执行,也不要把P100模块用于V100任务。
在已获分配的计算节点、作业环境内,可用:
nvidia-smi --query-gpu=index,memory.used,utilization.gpu --format=csv
用自己的Slurm监控方式定时采样,并同时保存任务日志和主机内存。资料包的新复跑驱动保留运行时间与输出,不自动重新采集GPU显存;图中的显存来自随包历史gpu.csv,不能把旧采样当作新任务数据。
3. 优先检查哪些设置#
| 变化 | 可能影响 |
|---|---|
| 增加原子数或轨道基组 | 矩阵规模、稀疏块及工作区 |
| 增大盒子、CUTOFF或REL_CUTOFF | 密度网格和相关缓存 |
| 改变HF/ADMM/筛选参数 | 积分与交换存储,且可能改变近似精度 |
| 增加MPI rank或让多rank共卡 | 设备上下文和部分重复数据 |
| 改对角化或其他求解器 | 独立工作区与分布方式 |
4. 显存不足时的处理顺序#
先确认错误发生在CPU内存还是GPU显存,是否存在其他进程、错误rank/卡映射或不匹配的并行参数;然后用自己的代表体系比较可用布局与算法。减少网格、换小基组或改变HF近似都涉及科学精度,不能只为降低占用直接改掉。
HF/MEMORY/MAX_MEMORY也不能当作所有后端通用的“每卡显存上限”开关。显存更大的设备可能容纳更大的工作区,但本专题没有V100 32GB容量实测,不据此给出该设备的体系上限。