
CP2K基组优化:H₂O参考与OPTIMIZE_BASIS
用收敛的水分子参考态演示H/O基组系数优化、派生基组、加权目标和实际迭代曲线。
阅读本篇目录
调整Gaussian基组的指数或收缩系数,需要专用的参考态与目标函数。CP2K的OPTIMIZE_BASIS可以同时处理多个元素和多种派生基组,本篇用一个H₂O参考演示最短可操作流程。
本例只针对一个水分子,采用较低教学网格和有限优化预算;得到的基组不作为可迁移的生产基组推荐。真正基组开发需要更多训练体系、独立验证和收敛测试。
1. 下载与看实际曲线#
下载本篇完整输入、实际结果与绘图资料包,保存为example.zip:
python3 -m zipfile -e example.zip .
cd cp2k-optimize-basis-water
bash results.sh
bash read.sh
bash plot.sh
这些命令先读取随包真实结果,CSV在data/,原生输出在reference-results/,生成的图在figures/。无需为看图重做计算。
2. 第一步:生成参考波函数#
参考为3原子水、8 Å盒、PADE/GTH-PADE、TZV2P-MOLOPT-GTH,网格截断100 Ry。EPS_SCF=1E-6,MAX_SCF=100,本次23步收敛。100 Ry仅用于本例教学,不是生产水体系推荐截断。
cat inputs/H2O-ref.inp
&GLOBAL
  PRINT_LEVEL LOW
  PROJECT refH2O
  RUN_TYPE ENERGY
&END GLOBAL

&FORCE_EVAL
  METHOD Quickstep
  &DFT
    BASIS_SET_FILE_NAME BASIS_MOLOPT
    POTENTIAL_FILE_NAME POTENTIAL
    &MGRID
      CUTOFF 100
    &END MGRID
    &QS
      EPS_DEFAULT 1.0E-12
      EXTRAPOLATION PS
      EXTRAPOLATION_ORDER 3
    &END QS
    &SCF
      EPS_SCF 1.0E-6
      MAX_SCF 100
      SCF_GUESS ATOMIC
      &OT
      &END OT
    &END SCF
    &XC
      &XC_FUNCTIONAL Pade
      &END XC_FUNCTIONAL
    &END XC
  &END DFT
  &SUBSYS
    &CELL
      ABC 8.0 8.0 8.0
    &END CELL
    &COORD
      O   0.000000    0.000000   -0.065587
      H   0.000000   -0.757136    0.520545
      H   0.000000    0.757136    0.520545
    &END COORD
    &KIND H
      BASIS_SET TZV2P-MOLOPT-GTH
      POTENTIAL GTH-PADE-q1
    &END KIND
    &KIND O
      BASIS_SET TZV2P-MOLOPT-GTH
      POTENTIAL GTH-PADE-q6
    &END KIND
  &END SUBSYS
&END FORCE_EVAL
计算阶段首先执行:
mpirun -np 4 cp2k.psmp -i H2O-ref.inp > reference.out
得到refH2O-RESTART.wfn后再进入基组优化。后面的脚本复用这个参考文件,不为每次目标评价重新做参考SCF。
3. 第二步:定义要优化的基组#
本例从H和O的TZVP-MOLOPT-GTH出发,只开放收缩系数,原Gaussian指数保持不变;再按输入删减收缩构造两级派生基组,形成三种H/O组合。
cat inputs/budget500/opt-1.inp
展开完整基组优化输入
#CPQA DEPENDS H2O-ref.inp
&GLOBAL
  PROGRAM_NAME OPTIMIZE_BASIS
  PROJECT optbas-1
&END GLOBAL

&OPTIMIZE_BASIS
  ! specify basis set combinations for H and O being fitted together
  BASIS_COMBINATIONS 0 0
  BASIS_COMBINATIONS 1 1
  BASIS_COMBINATIONS 2 2
  ! BASIS_OUTPUT_FILE contains the result basis and intermediate basis set. Can be directly used with CP2K
  BASIS_OUTPUT_FILE myout
  ! BASIS_TEMPLATE_FILE contains a basis set which is used as a starting point for optimization
  BASIS_TEMPLATE_FILE BASIS_MOLOPT
  ! BASIS_WORK_FILE contains the basis set generated with the information below
  BASIS_WORK_FILE WORK_BASIS_STRUCTURE
  ! specify the weights on the CN for all combinations
  CONDITION_WEIGHT 0.001  ! 0 0
  CONDITION_WEIGHT 0.001  ! 1 1
  CONDITION_WEIGHT 0.01  ! 2 2
  ! specify the weights on the residuums for all combinations
  RESIDUUM_WEIGHT 100  ! 0 0
  RESIDUUM_WEIGHT 10  ! 1 1
  RESIDUUM_WEIGHT 1.0  ! 2 2
  ! include LOG(condition_number) in the fit
  USE_CONDITION_NUMBER
  ! output frquency for new basis file anjd opt info
  WRITE_FREQUENCY 50
  ! informations for the basis sets to be fitted. If nothing is specified basis from
  ! training input will be used
  &FIT_KIND H
    BASIS_SET TZVP-MOLOPT-GTH  ! will be reference set 0
    INITIAL_DEGREES_OF_FREEDOM COEFFICIENTS
    ! Generate additional basis sets
    !   DZVP basis
    &DERIVED_BASIS_SETS  ! reference set 1
      REMOVE_CONTRACTION 1 0 3
    &END DERIVED_BASIS_SETS
    !   SZV basis
    &DERIVED_BASIS_SETS  ! reference set 2
      REFERENCE_SET 1
      REMOVE_CONTRACTION 1 0 2
      REMOVE_CONTRACTION 1 1 1
    &END DERIVED_BASIS_SETS
  &END FIT_KIND
  &FIT_KIND O
    BASIS_SET TZVP-MOLOPT-GTH  ! reference set 0
    INITIAL_DEGREES_OF_FREEDOM COEFFICIENTS
    &DERIVED_BASIS_SETS  ! reference set 1
      BASIS_SET_NAME DZVP-MOLOPT-GTH
      REMOVE_CONTRACTION 1 0 3
      REMOVE_CONTRACTION 1 1 3
    &END DERIVED_BASIS_SETS
    &DERIVED_BASIS_SETS  ! reference set 2
      BASIS_SET_NAME SZV-MOLOPT-GTH
      REFERENCE_SET 1
      REMOVE_CONTRACTION 1 0 2
      REMOVE_CONTRACTION 1 1 2
      REMOVE_CONTRACTION 1 2 1
    &END DERIVED_BASIS_SETS
  &END FIT_KIND
  ! number of procs can be assigned for every calcualtion
  !   GROUP_PARTITION 4 4 2
  ! information for optimization
  &OPTIMIZATION
    MAX_FUN 500
  &END OPTIMIZATION
  ! path to input files and directory for the QS calculations and the restart files
  &TRAINING_FILES
    INPUT_FILE_NAME H2O-ref.inp
  &END TRAINING_FILES
&END OPTIMIZE_BASIS
| 控制 | 本例作用 |
|---|---|
BASIS_TEMPLATE_FILE |
原始基组数据 |
FIT_KIND H/O |
分别定义元素与起始基组 |
INITIAL_DEGREES_OF_FREEDOM COEFFICIENTS |
本例仅优化收缩系数 |
DERIVED_BASIS_SETS |
由同一组参数生成较小基组 |
BASIS_COMBINATIONS |
同时评价的H/O组合 |
RESIDUUM_WEIGHT |
各组合的目标权重 |
USE_CONDITION_NUMBER |
把条件数相关项纳入目标 |
BASIS_OUTPUT_FILE myout |
写出可供CP2K读取的基组文件 |
目标包含加权的能量、密度残差与条件数相关项,因此数值可以为负,不能把纵轴称作“非负均方误差”。
4. 提交与计数#
使用集群cp2k/2026.2-8173m,Intel oneAPI 2024.2与Intel MPI构建,CPU路径。本包给出CPU整节点56核申请,MPI进程每个1线程。准备新计算时,在新解压目录执行:
sbatch run.slurm
任务结束后读取自己的输出:
bash read.sh work analysis-new
bash plot.sh analysis-new figures-new work
不要把实际计算直接放到登录节点。没有CPU资源时仍可先读已保存的结果。
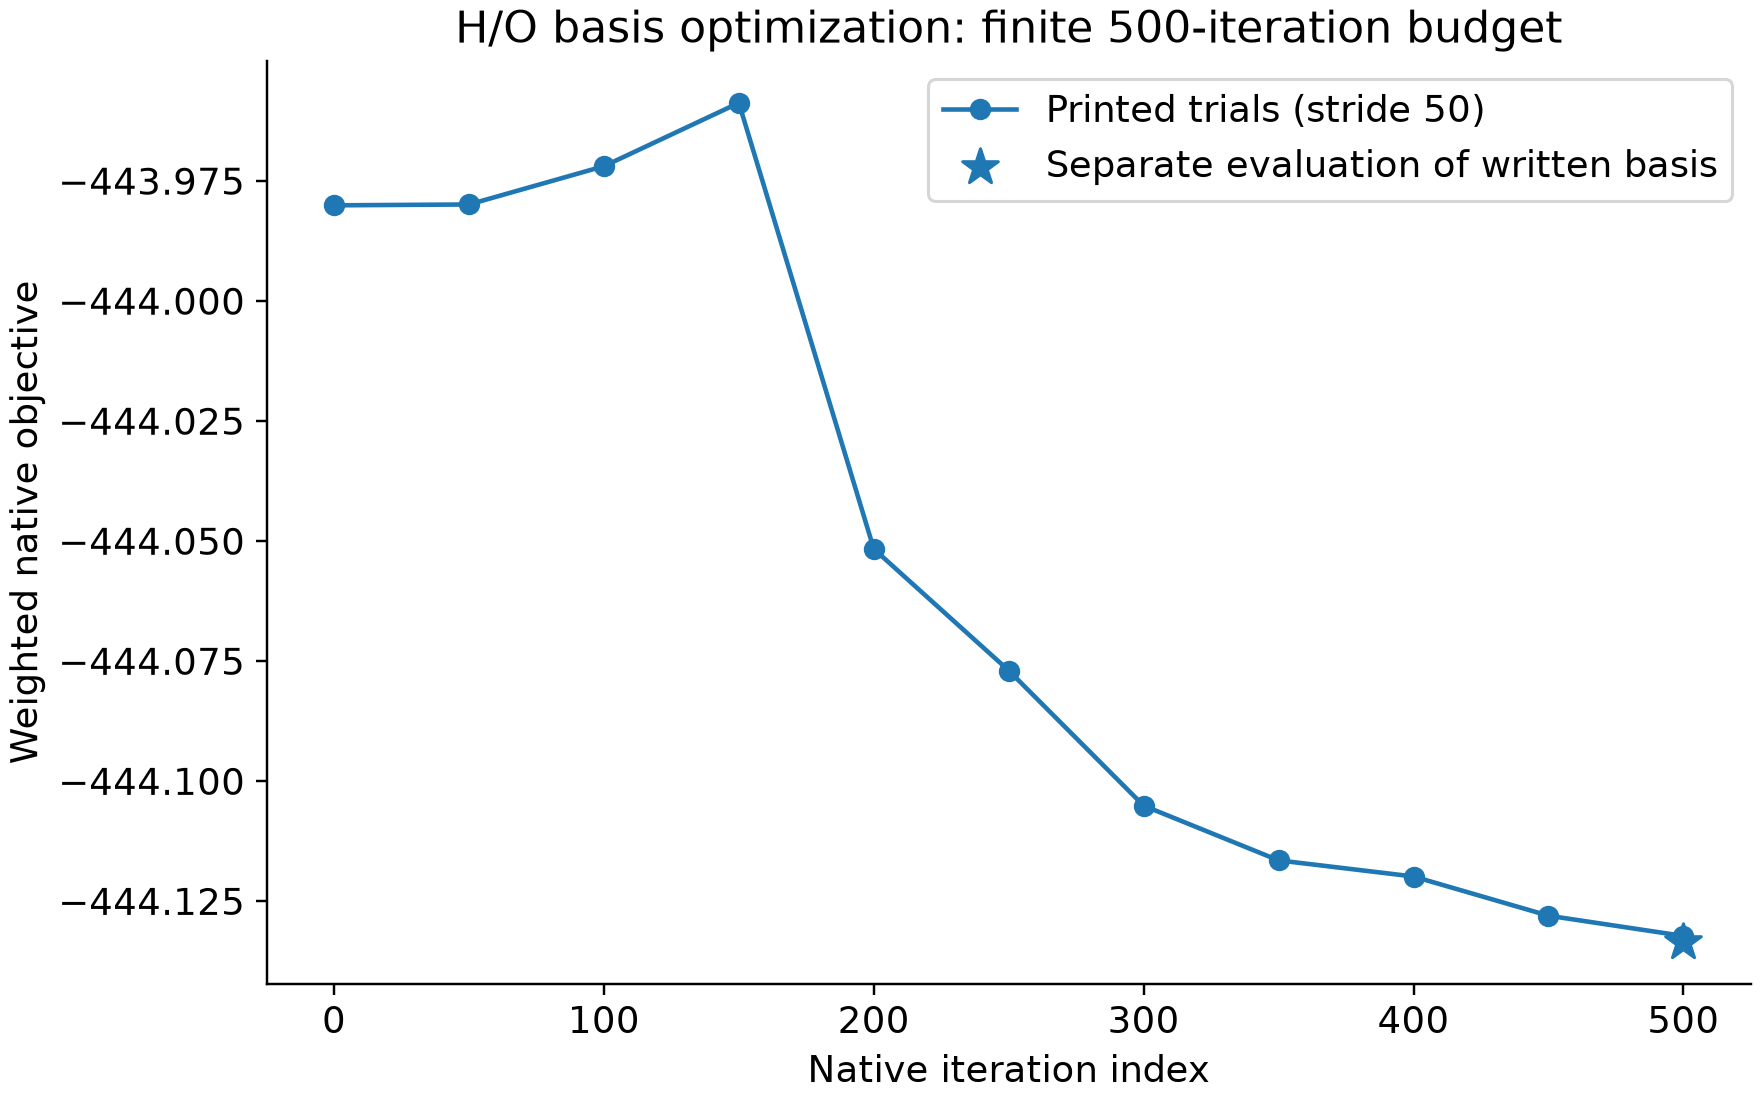
本包使用4个MPI进程。MAX_FUN 500在此原生实现中对应循环索引0至500,共501次目标评价;WRITE_FREQUENCY 50只输出11个采样记录,不是只计算了11次。
grep -E 'iteration number|Total residuum' reference-results/budget500/fit-native.log
cat data/CP2K-basis-objective-history.csv
初始目标约−443.98011,最后打印试探点约−444.13228。程序在结尾处理优化器状态并写出myout,因此不能直接把最后一条试探点当成最终基组的精确目标值。本例另行将实际myout作为模板读回,得到目标约−444.13350。
5. 下一步怎样用#
head -n 12 reference-results/budget500/myout
cat data/CP2K-basis-H2O-singlepoints.csv
将生成的文件用于真实输入,并重新做SCF收敛与独立验证,见输出基组的读取与使用。