
PLUMED向量处理:展平、分量选择与掩码
32帧四原子构型实际驱动FLATTEN、SELECT_COMPONENTS、SELECT_WITH_MASK与矩阵对角操作。
阅读本篇目录
把多个集体变量组成向量后,可以选择子集、按掩码过滤或把矩阵展平。本例用PLUMED2.10.1的原生driver逐帧操作,保留每个分量的实际输出,便于接到自己的多CV分析流程。
1. 下载与结果#
下载完整输入、原生结果和绘图包,保存为example.zip:
python3 -m zipfile -e example.zip .
cd plumed-feature-distances
bash results.sh
bash read.sh
bash plot.sh
这些命令直接读取随包实算结果;reference-results/存原生输出,data/存CSV,figures/存图片。read.sh和plot.sh默认使用集群ASE环境的Python,无需重新计算。自己的Python须安装NumPy、ASE和Matplotlib,可用YS_ANALYSIS_PYTHON指定解释器。
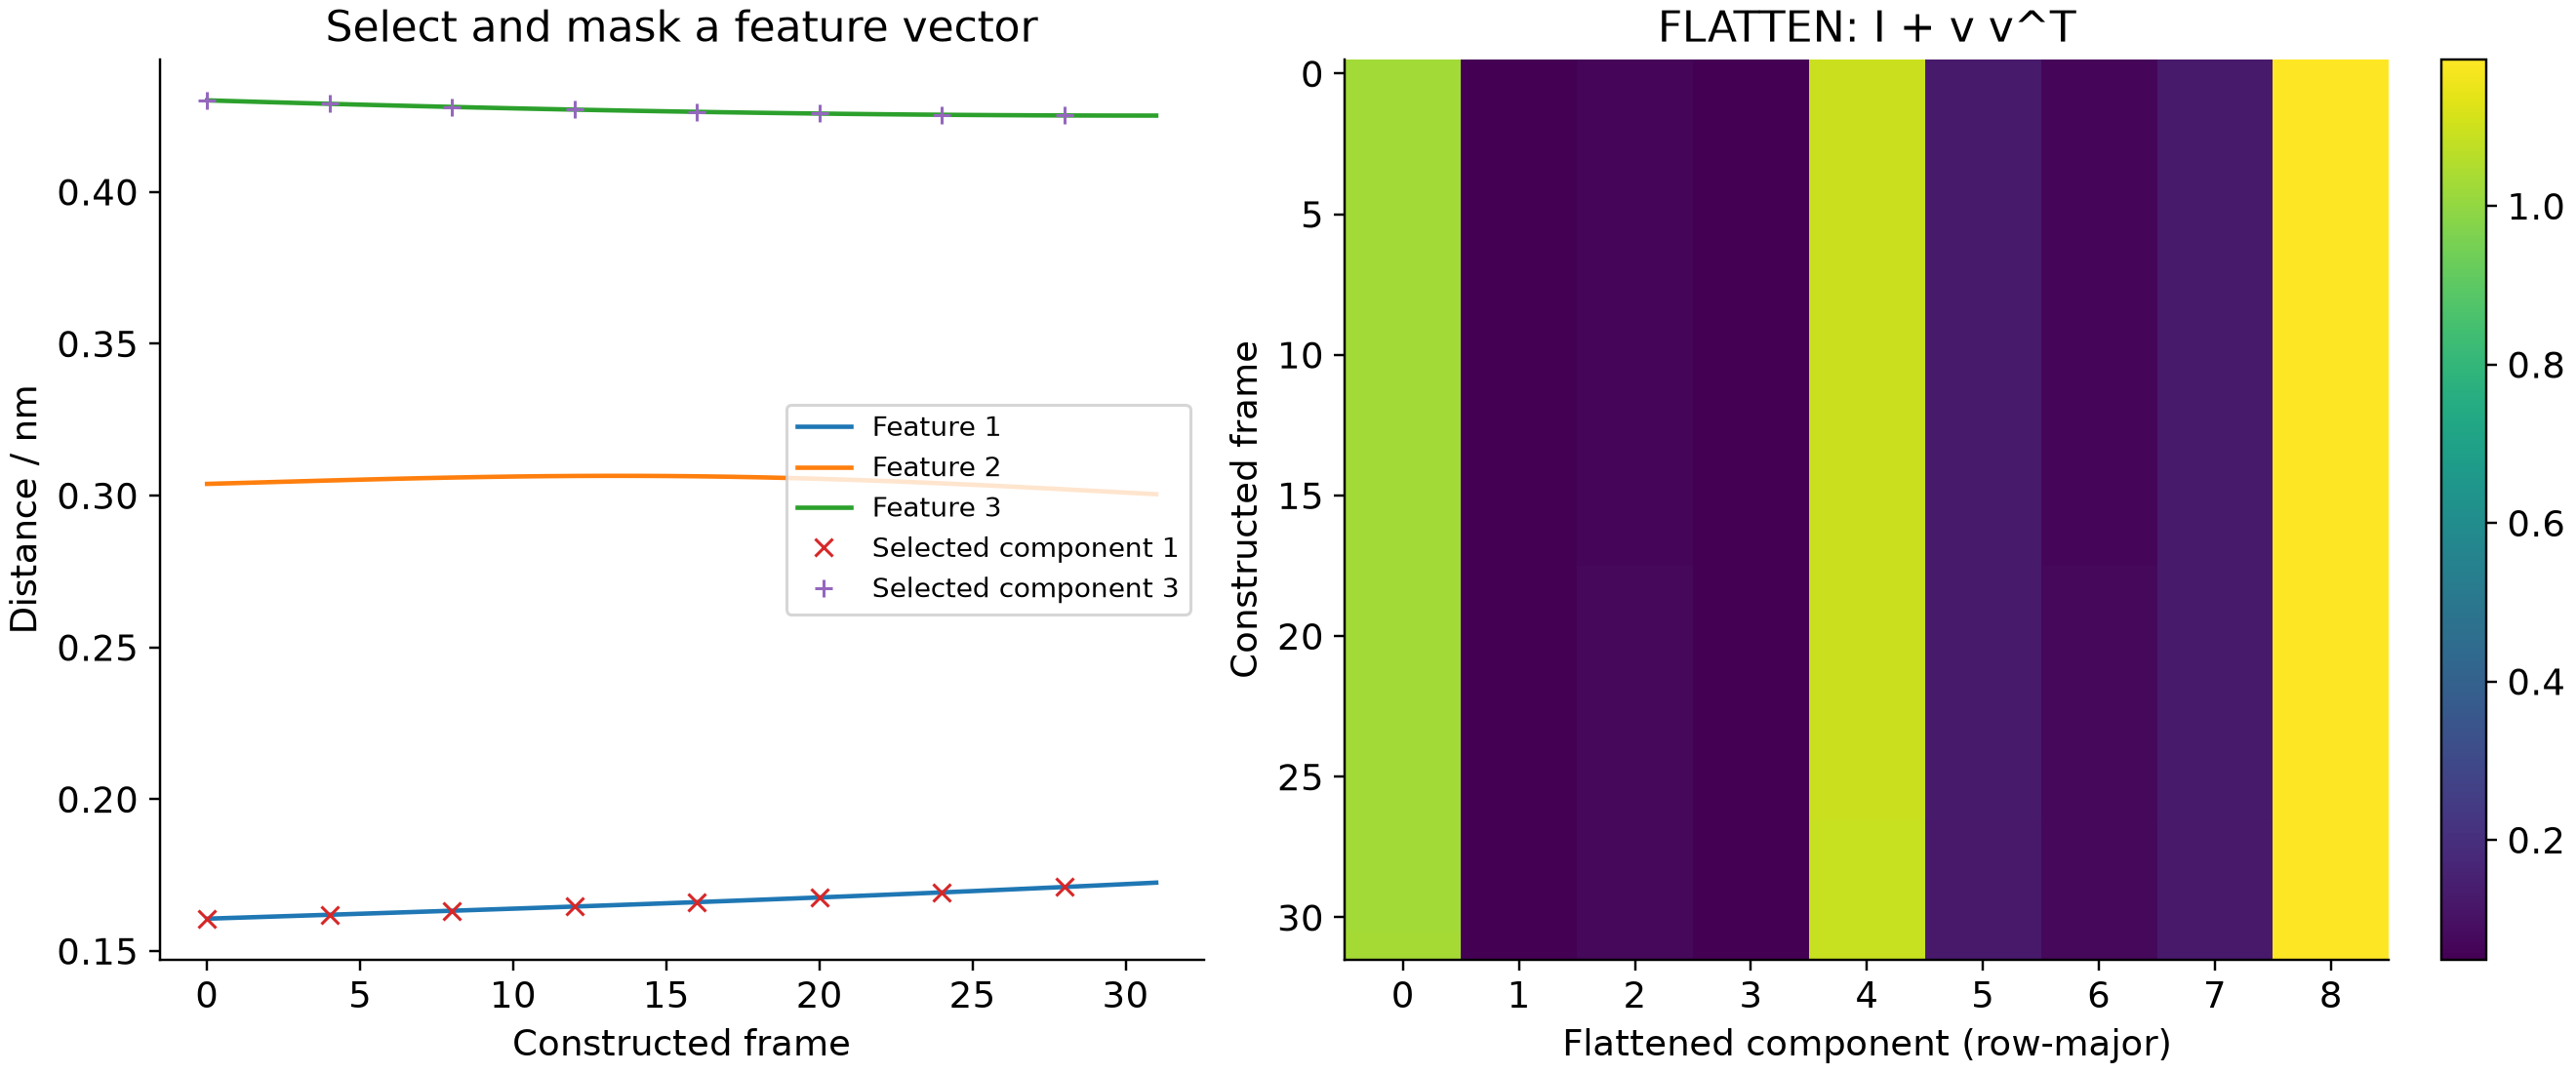
本例是32帧人为生成的四原子几何序列,坐标单位nm,不是经过动力学积分的MD轨迹。特征取原子1到2、3、4的三个非周期距离。作为CV空间向量时,数值按1 nm归一化理解。
2. 完整PLUMED输入#
cat inputs/plumed.dat
head -n 12 inputs/scan.xyz
UNITS LENGTH=nm ENERGY=kj/mol TIME=ps
r: DISTANCE ATOMS=1,2 NOPBC
s: DISTANCE ATOMS=1,3 NOPBC
t: DISTANCE ATOMS=1,4 NOPBC
v: CONCATENATE ARG=r,s,t
ref: CONSTANT VALUES=0.2,0.3,0.05
weights: CONSTANT VALUES=4,1,0.25
metric: CONSTANT NROWS=3 NCOLS=3 VALUES=4,0.3,0.2,0.3,1,0.1,0.2,0.1,0.25
mask: CONSTANT VALUES=0,1,0
out: OUTER_PRODUCT ARG=v,v
identity: CONSTANT NROWS=3 NCOLS=3 VALUES=1,0,0,0,1,0,0,0,1
m: CUSTOM ARG=out,identity FUNC=x+y PERIODIC=NO
flat: FLATTEN ARG=m
pick: SELECT_COMPONENTS ARG=v COMPONENTS=1,3
masked: SELECT_WITH_MASK ARG=v MASK=mask
displacement: DISPLACEMENT ARG1=v ARG2=ref
difference: DIFFERENCE ARG=v,ref
euclidean: EUCLIDEAN_DISTANCE ARG1=v ARG2=ref
normalized: NORMALIZED_EUCLIDEAN_DISTANCE ARG1=v ARG2=ref METRIC=weights
mahalanobis: MAHALANOBIS_DISTANCE ARG1=v ARG2=ref METRIC=metric
diagonal: MATRIX_PRODUCT_DIAGONAL ARG=m,metric
PRINT ARG=r,s,t,euclidean,normalized,mahalanobis STRIDE=1 FILE=COLVAR FMT=%.14g
DUMPVECTOR ARG=flat STRIDE=1 FILE=flat.dat FMT=%.14g PRINT_ONE_FILE
DUMPVECTOR ARG=pick STRIDE=1 FILE=pick.dat FMT=%.14g PRINT_ONE_FILE
DUMPVECTOR ARG=masked STRIDE=1 FILE=masked.dat FMT=%.14g PRINT_ONE_FILE
DUMPVECTOR ARG=displacement STRIDE=1 FILE=displacement.dat FMT=%.14g PRINT_ONE_FILE
DUMPVECTOR ARG=difference STRIDE=1 FILE=difference.dat FMT=%.14g PRINT_ONE_FILE
DUMPVECTOR ARG=diagonal STRIDE=1 FILE=diagonal.dat FMT=%.14g PRINT_ONE_FILE
其中:
v: CONCATENATE ARG=r,s,t
pick: SELECT_COMPONENTS ARG=v COMPONENTS=1,3
mask: CONSTANT VALUES=0,1,0
masked: SELECT_WITH_MASK ARG=v MASK=mask
SELECT_COMPONENTS的索引从1起,选第1和第3个分量。这里SELECT_WITH_MASK中1表示丢弃,0表示保留,所以同样留下r和t;不要按常见“1代表选中”的习惯反过来写。
3. 矩阵与展平#
out: OUTER_PRODUCT ARG=v,v
identity: CONSTANT NROWS=3 NCOLS=3 VALUES=1,0,0,0,1,0,0,0,1
m: CUSTOM ARG=out,identity FUNC=x+y PERIODIC=NO
flat: FLATTEN ARG=m
本例构造M=I+vvᵀ,FLATTEN逐行展成9个分量。MATRIX_PRODUCT_DIAGONAL ARG=m,metric还输出矩阵乘积的3个对角元素。本例两矩阵对称;不要据此单独验证任意非对称输入的乘积方向。
4. 执行短前后处理#
新解压目录可直接运行单线程driver:
bash run.sh
bash read.sh work analysis-new
bash plot.sh analysis-new figures-new work
集群的PLUMED2.10.1位于CP2K2026.2依赖环境,底层命令为:
module load cp2k/2026.2-8173m
plumed_root=/public/software/cp2k/deps/2026.2/8173m/plumed-2.10.1
export LD_LIBRARY_PATH="$plumed_root/lib:${LD_LIBRARY_PATH:-}"
"$plumed_root/bin/plumed" driver --plumed plumed.dat --ixyz scan.xyz --length-units nm --box 1,1,1
工作目录要先放入plumed.dat和scan.xyz。本例NOPBC用于四原子非周期距离,盒参数不是让轨迹自动具备周期意义。
5. 看实际数据#
head reference-results/pick.dat
head reference-results/masked.dat
head reference-results/flat.dat
head data/PLUMED-feature-vector-checks.csv
所有32帧的选中分量、掩码、展平和矩阵对角值均与独立NumPy逐项计算一致,最大差约5×10⁻¹⁴。DUMPVECTOR文件有时间/分量索引等列,读入后应按每帧的实际分量数重排,不能把所有行当成独立轨迹帧。
使用自己轨迹时,先替换原子选择、单位、PBC与向量构造,再考虑更长轨迹的抽样间隔和输出量。