
PLUMED导出PDB:位置矩阵和最后一帧快照
实际用DUMPPDB的1×3N值矩阵导出四粒子快照,说明坐标排列、原子编号、Å单位和BETA注释。
阅读本篇目录
这一版本DUMPPDB的ATOMS接收位置值矩阵,不能直接照搬ATOMS=1-4。本篇把输入XYZ的最后一帧明确准备成矩阵,再导出PDB,逐坐标比较结果。
1. 下载与实际导出#
下载完整输入、原生结果和绘图包,保存为example.zip:
python3 -m zipfile -e example.zip .
cd plumed-mass-charge-centers
bash results.sh
bash read.sh
bash plot.sh
先读取保存的真实结果;原生输出在reference-results/qualified/,CSV在data/,图在figures/。默认使用集群ASE环境Python,可用YS_ANALYSIS_PYTHON指定含NumPy、ASE和Matplotlib的解释器。
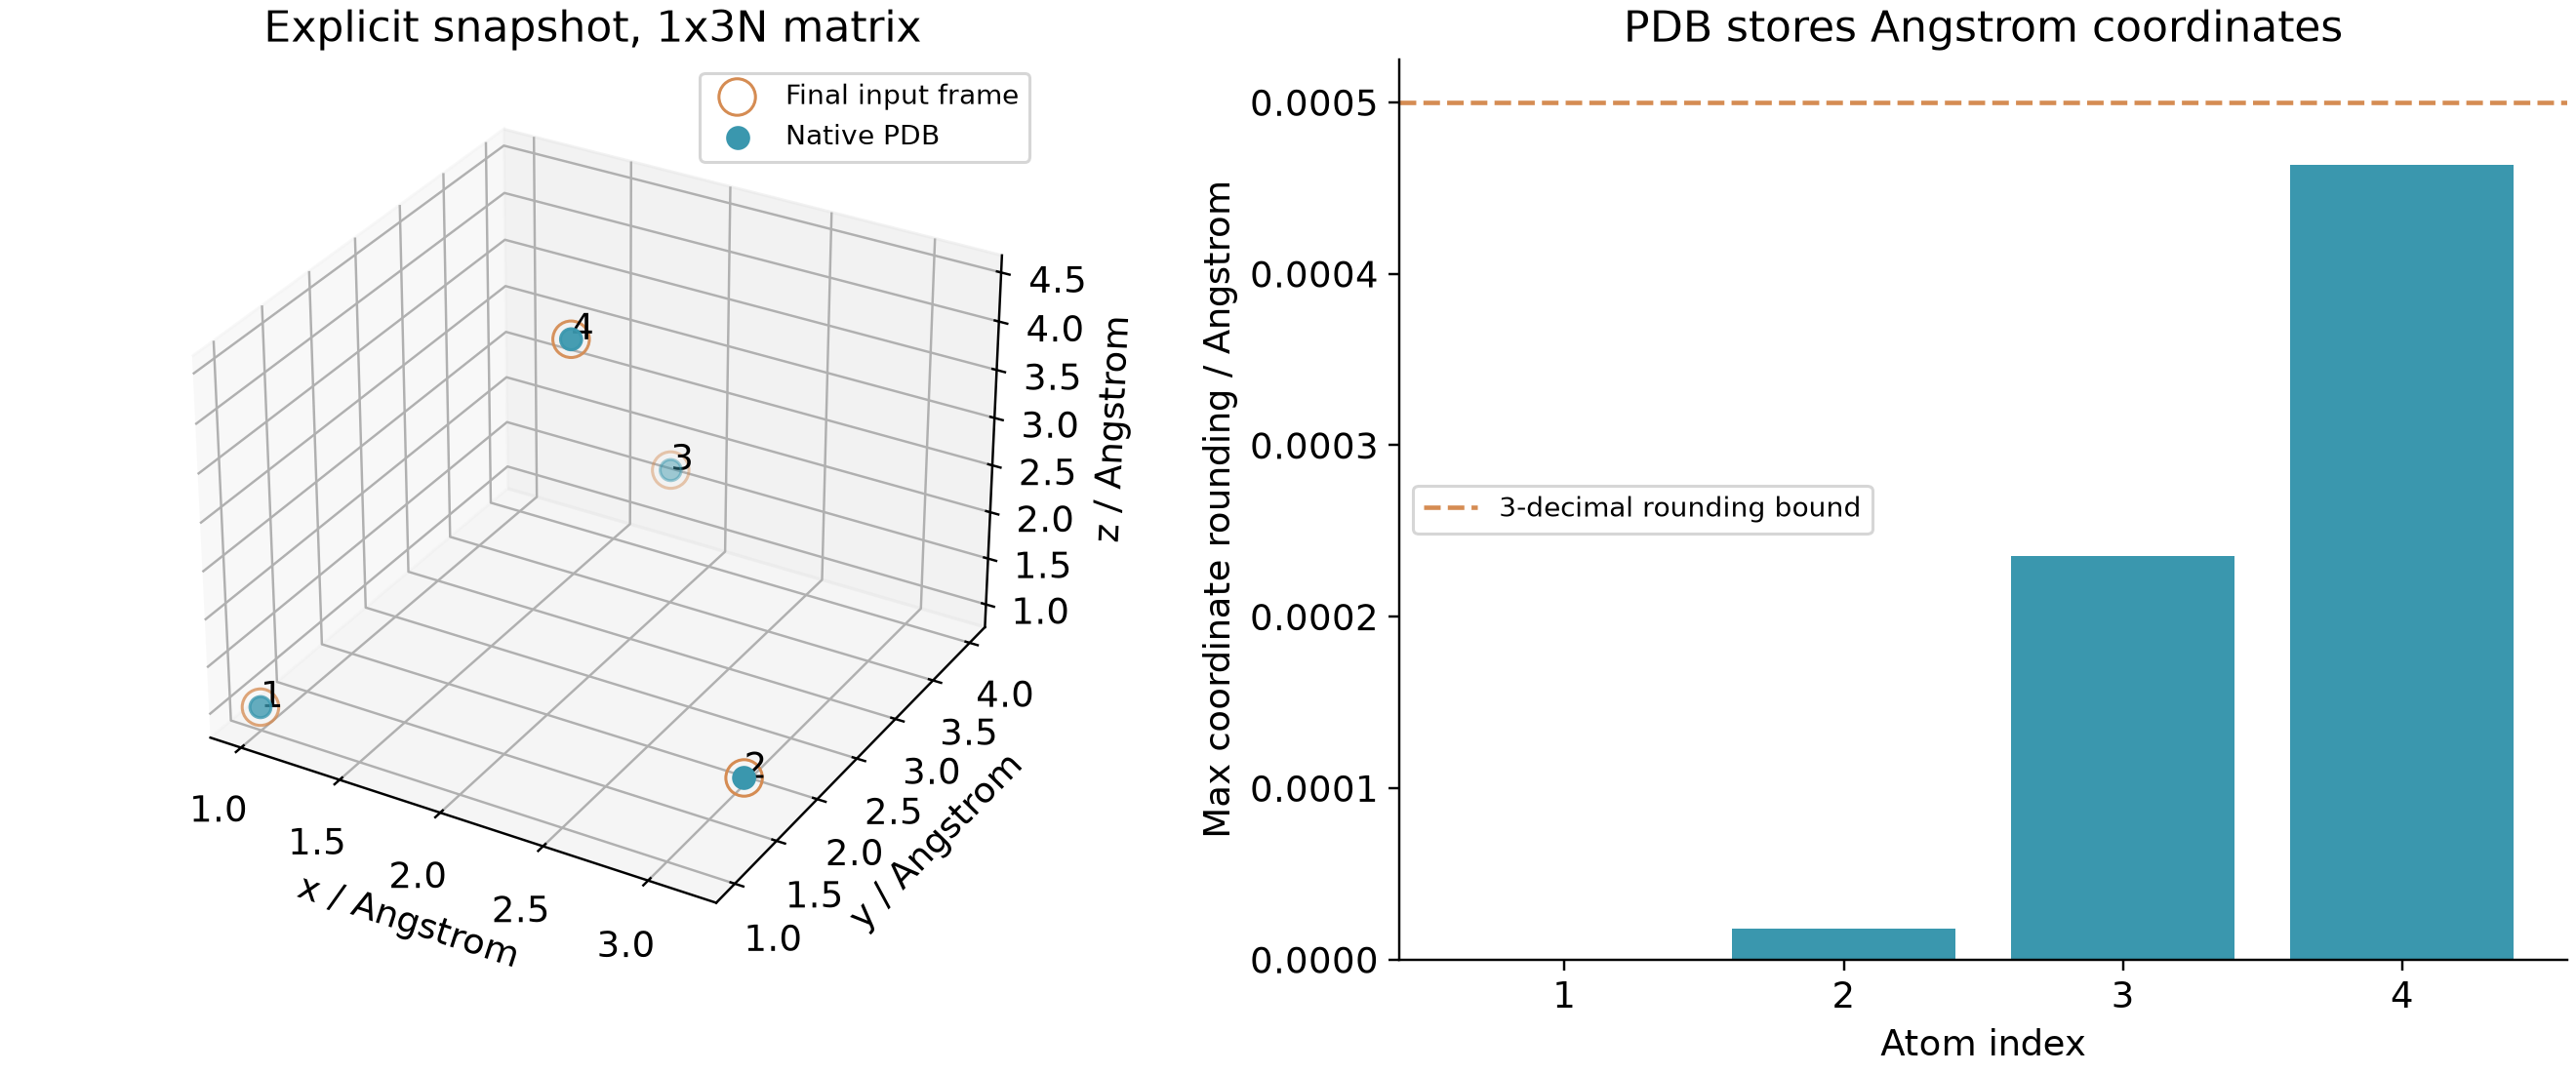
本例导出的是明确选定的最后一帧输入快照,没有把它说成自动保存整条活动轨迹。
2. 位置矩阵怎样排列#
四个粒子的一帧坐标用1×12矩阵保存,排列为:
x1,x2,x3,x4,y1,y2,y3,y4,z1,z2,z3,z4
它不是x1,y1,z1,x2,y2,z2,...。原生调用为:
DUMPPDB ATOMS=snapshot ATOM_INDICES=1-4 FILE=final.pdb STRIDE=0 OCCUPANCY=1,1,1,1 BETA=1,-1,0.5,-0.5
snapshot在本例定义为CONSTANT NROWS=1 NCOLS=12,ATOM_INDICES列出要写出的原子编号。STRIDE=0在结束时写这张快照,OCCUPANCY和BETA明确给四个值。
3. 怎样从自己的输入生成#
cat inputs/plumed.dat
随包prepare_snapshot.py读取本例四粒子XYZ最后一帧,按上述顺序生成矩阵。run.py先复制输入到新work/qualified/,自动调用准备脚本,再运行PLUMED;修改原来的32帧输入后,快照会重新从新输入的最后一帧取得。
在新解压目录运行短串行driver:
bash run.sh
bash read.sh work analysis-new
bash plot.sh analysis-new figures-new work
程序采用CP2K2026.2依赖中的PLUMED2.10.1,run.py已设置程序和动态库路径。本包只有坐标前后处理,没有做DFT、力场参数拟合或物理MD。
若只想更新未运行的本例输入快照,可先在另一个副本执行:
py=/public/toolkit/miniconda3/envs/ase-3.29.0/bin/python
"$py" prepare_snapshot.py inputs
这个辅助脚本针对本例四粒子布局;换原子数时,需要同步矩阵列数、坐标排列、原子编号和注释数组,不能只改XYZ第一行。
4. 读PDB与单位#
cat reference-results/qualified/final.pdb
cat data/PLUMED-PDB-snapshot-coordinates.csv
输入和PLUMED内部长度按nm设置,原生PDB写Å,所以坐标乘10。PDB本例保留三位小数,最大坐标舍入约4.63×10⁻⁴ Å;不能要求它像高精度XYZ或VASP坐标一样保留所有小数。
输出原子名是通用X,不携带真实化学元素识别、键或力场拓扑。本例OCCUPANCY全为1,BETA列存我们选择写出的赋值电荷注释,不能当作实验热参数。它用于几何展示和分析注释,不直接替代完整模拟拓扑。
接口细节见PLUMED DUMPPDB原生实现。