
CP2K优化基组怎么用:myout、命名与单点对照
把实际优化输出基组交回CP2K,检查名称、系数和收敛单点,区分目标改善与可迁移性。
阅读本篇目录
基组优化完成后,应确认程序写出的文件能被真正的CP2K计算读取。本篇使用前一篇基组优化的实际myout,对同一个水分子做原始TZVP与优化TZVP的单点比较。
1. 先看已经完成的数据#
下载本篇完整输入、实际结果与绘图资料包,保存为example.zip:
python3 -m zipfile -e example.zip .
cd cp2k-optimize-basis-water
bash results.sh
bash read.sh
bash plot.sh
这些命令先读取随包真实结果,CSV在data/,原生输出在reference-results/,生成的图在figures/。无需为看图重做计算。
2. 看基组名称#
grep -E '^[HO] ' reference-results/budget500/myout
head -n 12 reference-results/budget500/myout
文件中有H/O各三套基组:原尺寸与两级派生尺寸。输入中的KIND/BASIS_SET必须与文件里的实际名称一致,不能因为文件名叫myout就把基组名称也写成myout。
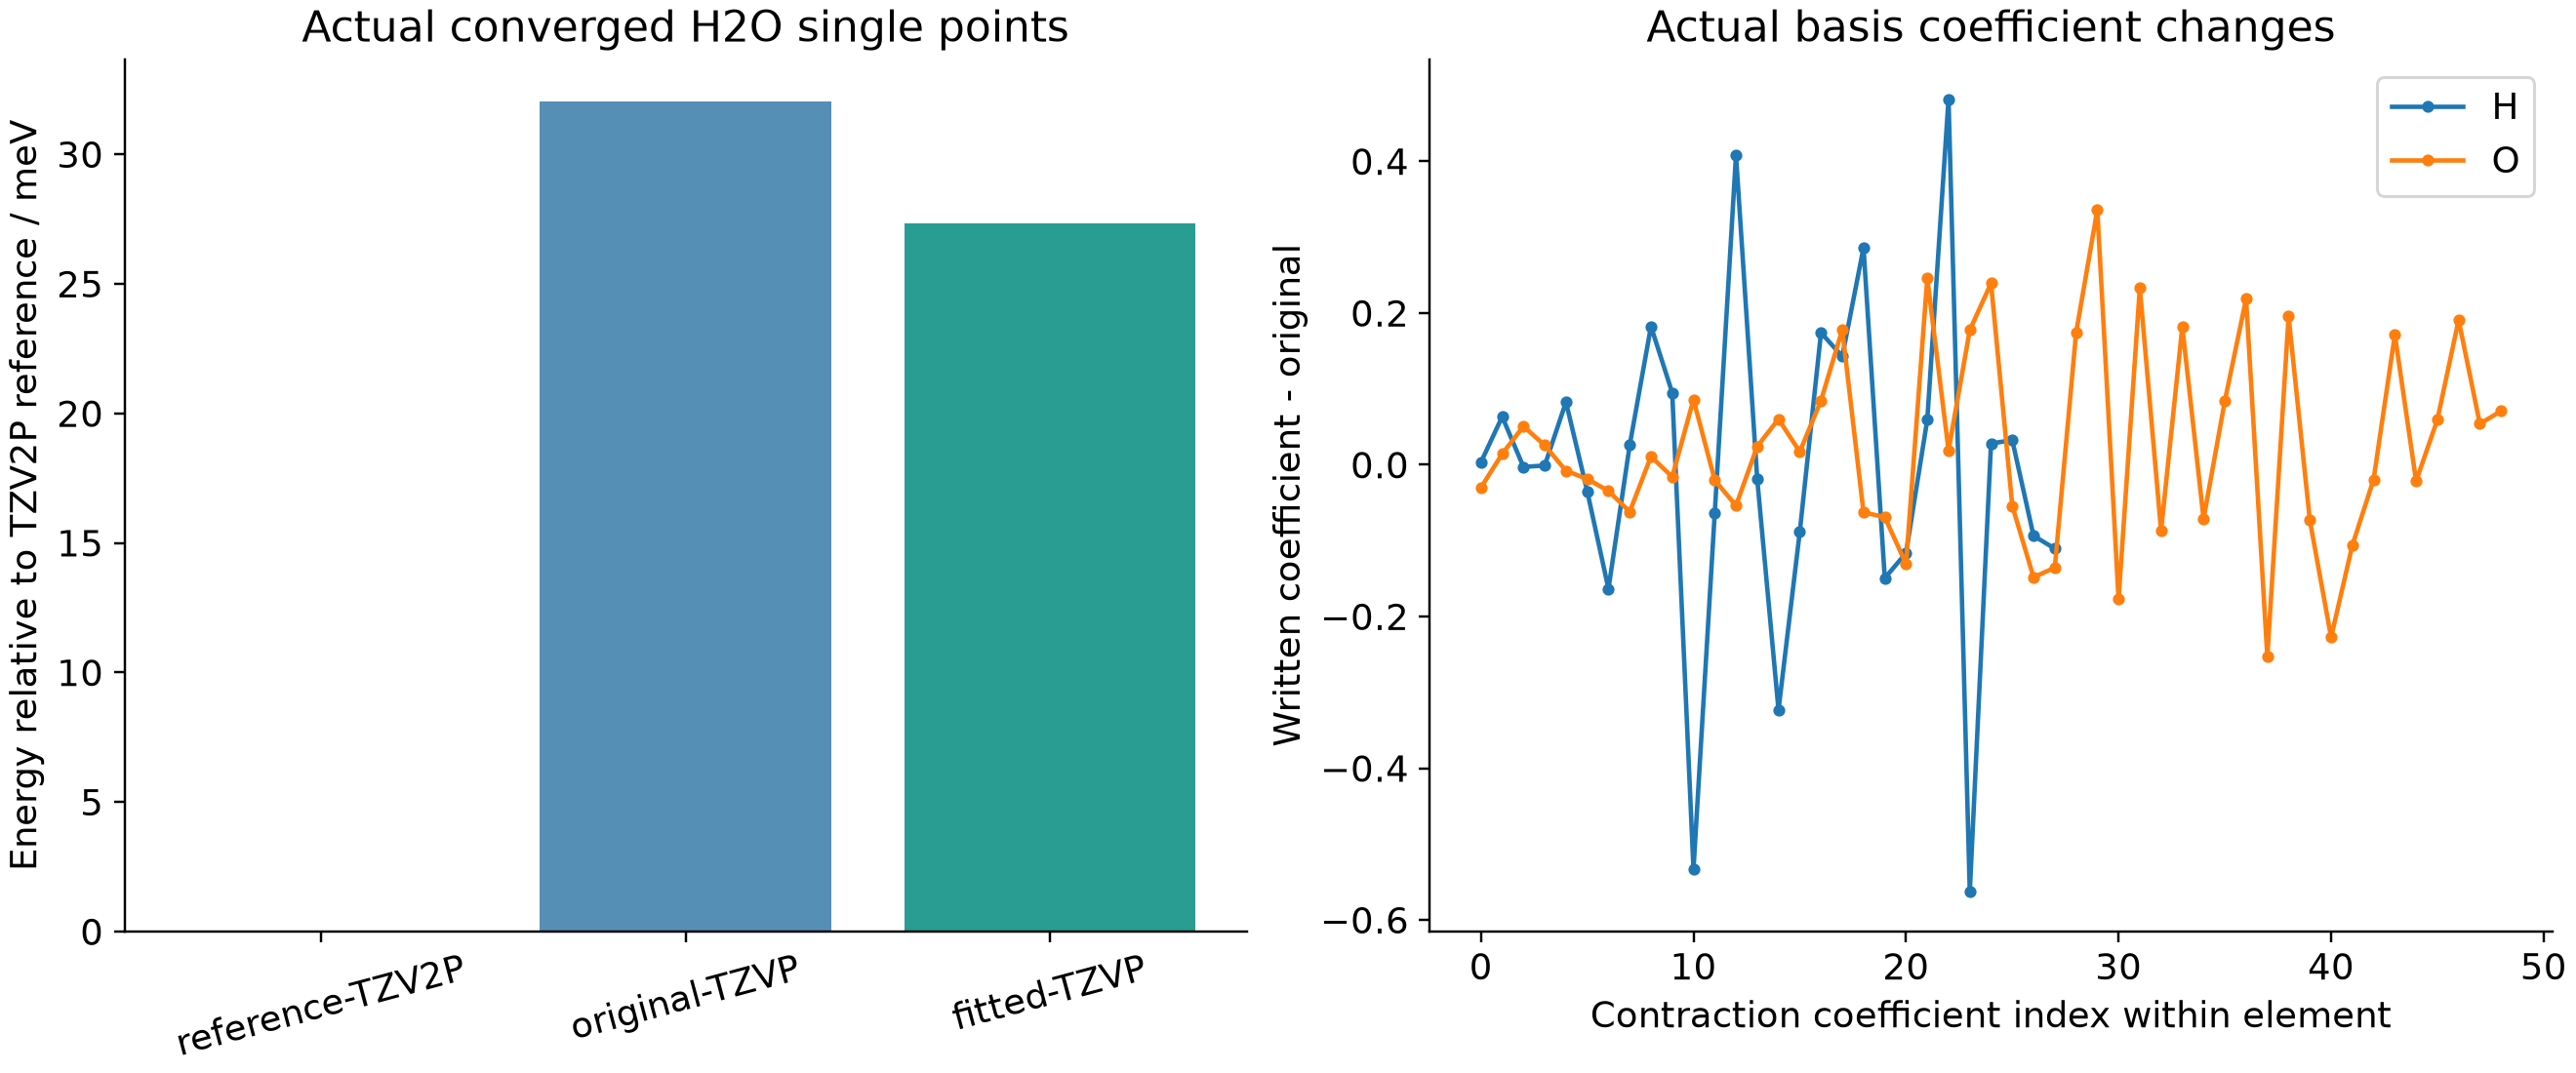
本例Gaussian指数没有改变,收缩系数有实际变化;全部系数记录见:
head data/CP2K-basis-coefficient-changes.csv
3. 使用生成的基组#
本包将myout复制到一个独立计算目录,命名为BASIS_MOLOPT,这样输入中的文件名与原来一致,但实际内容来自新基组;原始公共文件不会被覆盖。
在自己的新目录也可以直接保留文件名:
mkdir h2o-new-basis
cp reference-results/budget500/myout h2o-new-basis/myout
cp inputs/POTENTIAL h2o-new-basis/POTENTIAL
cp inputs/budget500/verify/H2O-fitted/input.inp h2o-new-basis/input.inp
sed -i 's/BASIS_SET_FILE_NAME BASIS_MOLOPT/BASIS_SET_FILE_NAME myout/' h2o-new-basis/input.inp
完整单点输入为:
&GLOBAL
  PRINT_LEVEL LOW
  PROJECT fitted500
  RUN_TYPE ENERGY
&END GLOBAL

&FORCE_EVAL
  METHOD Quickstep
  &DFT
    BASIS_SET_FILE_NAME BASIS_MOLOPT
    POTENTIAL_FILE_NAME POTENTIAL
    &MGRID
      CUTOFF 100
    &END MGRID
    &QS
      EPS_DEFAULT 1.0E-12
      EXTRAPOLATION PS
      EXTRAPOLATION_ORDER 3
    &END QS
    &SCF
      EPS_SCF 1.0E-6
      MAX_SCF 100
      SCF_GUESS ATOMIC
      &OT
      &END OT
    &END SCF
    &XC
      &XC_FUNCTIONAL Pade
      &END XC_FUNCTIONAL
    &END XC
  &END DFT
  &SUBSYS
    &CELL
      ABC 8.0 8.0 8.0
    &END CELL
    &COORD
      O   0.000000    0.000000   -0.065587
      H   0.000000   -0.757136    0.520545
      H   0.000000    0.757136    0.520545
    &END COORD
    &KIND H
      BASIS_SET TZVP-MOLOPT-GTH
      POTENTIAL GTH-PADE-q1
    &END KIND
    &KIND O
      BASIS_SET TZVP-MOLOPT-GTH
      POTENTIAL GTH-PADE-q6
    &END KIND
  &END SUBSYS
&END FORCE_EVAL
使用上面重命名为myout的文件时,把输入中的BASIS_SET_FILE_NAME同步改成myout;其他基组名称不改。
4. 运行与比较#
使用集群cp2k/2026.2-8173m,Intel oneAPI 2024.2与Intel MPI构建,CPU路径。本包给出CPU整节点56核申请,MPI进程每个1线程。准备新计算时,在新解压目录执行:
sbatch run.slurm
任务结束后读取自己的输出:
bash read.sh work analysis-new
bash plot.sh analysis-new figures-new work
不要把实际计算直接放到登录节点。没有CPU资源时仍可先读已保存的结果。
整包脚本已经自动完成参考、原基组、优化、写出文件读回与新基组单点,不需再手工重复。查看结果:
grep 'SCF run converged' reference-results/post/original-native.log
grep 'SCF run converged' reference-results/budget500/verify/use-native.log
cat data/CP2K-basis-H2O-singlepoints.csv
| 基组 | 本例实际总能量/Eh |
|---|---|
| 参考TZV2P | −17.165077626462 |
| 原始TZVP | −17.163899599359 |
| 优化TZVP | −17.164073089684 |
两组TZVP使用相同分子、泛函、赝势、网格和SCF要求,优化后比原TZVP低约4.72 meV;这只是本例水分子的对照。TZV2P与TZVP尺寸不同,图中能量差也不能单独当作任意体系的基组误差上限。
5. 不要只读最后一个优化点#
grep 'Total residuum' reference-results/budget500/verify/verify-native.log
这里第一次评价读的是实际写出的基组,约−444.13350。它与原优化日志最后一个试探点−444.13228不同,说明“最后打印的点”和“实际输出文件”需要分别核对。
本例改进了单分子目标,但没有测试其他分子、键长、反应、体相或数值稳定性,因此仍应保留原生产基组,把新基组用于明确的研究与验证任务。