
PLUMED沿轨迹统计:运行平均、累加和样本收集
用32个真实driver样本演示AVERAGE、ACCUMULATE、COLLECT和TIME,说明初始化帧与空集合均值。
阅读本篇目录
沿轨迹反复采样一个CV,与对一帧中的多个分量求平均不同。本篇使用AVERAGE、ACCUMULATE、COLLECT和TIME,实际记录每个样本加入后的平均值与总和。
1. 下载与实际曲线#
下载完整输入、真实原生输出和绘图包,保存为example.zip:
python3 -m zipfile -e example.zip .
cd plumed-vector-time-statistics
bash results.sh
bash read.sh
bash plot.sh
上述命令先读随包已完成的结果;原生输出在reference-results/,CSV在data/,图在figures/。默认使用集群ASE环境中的Python,其他环境可用YS_ANALYSIS_PYTHON指定含NumPy、ASE和Matplotlib的解释器。
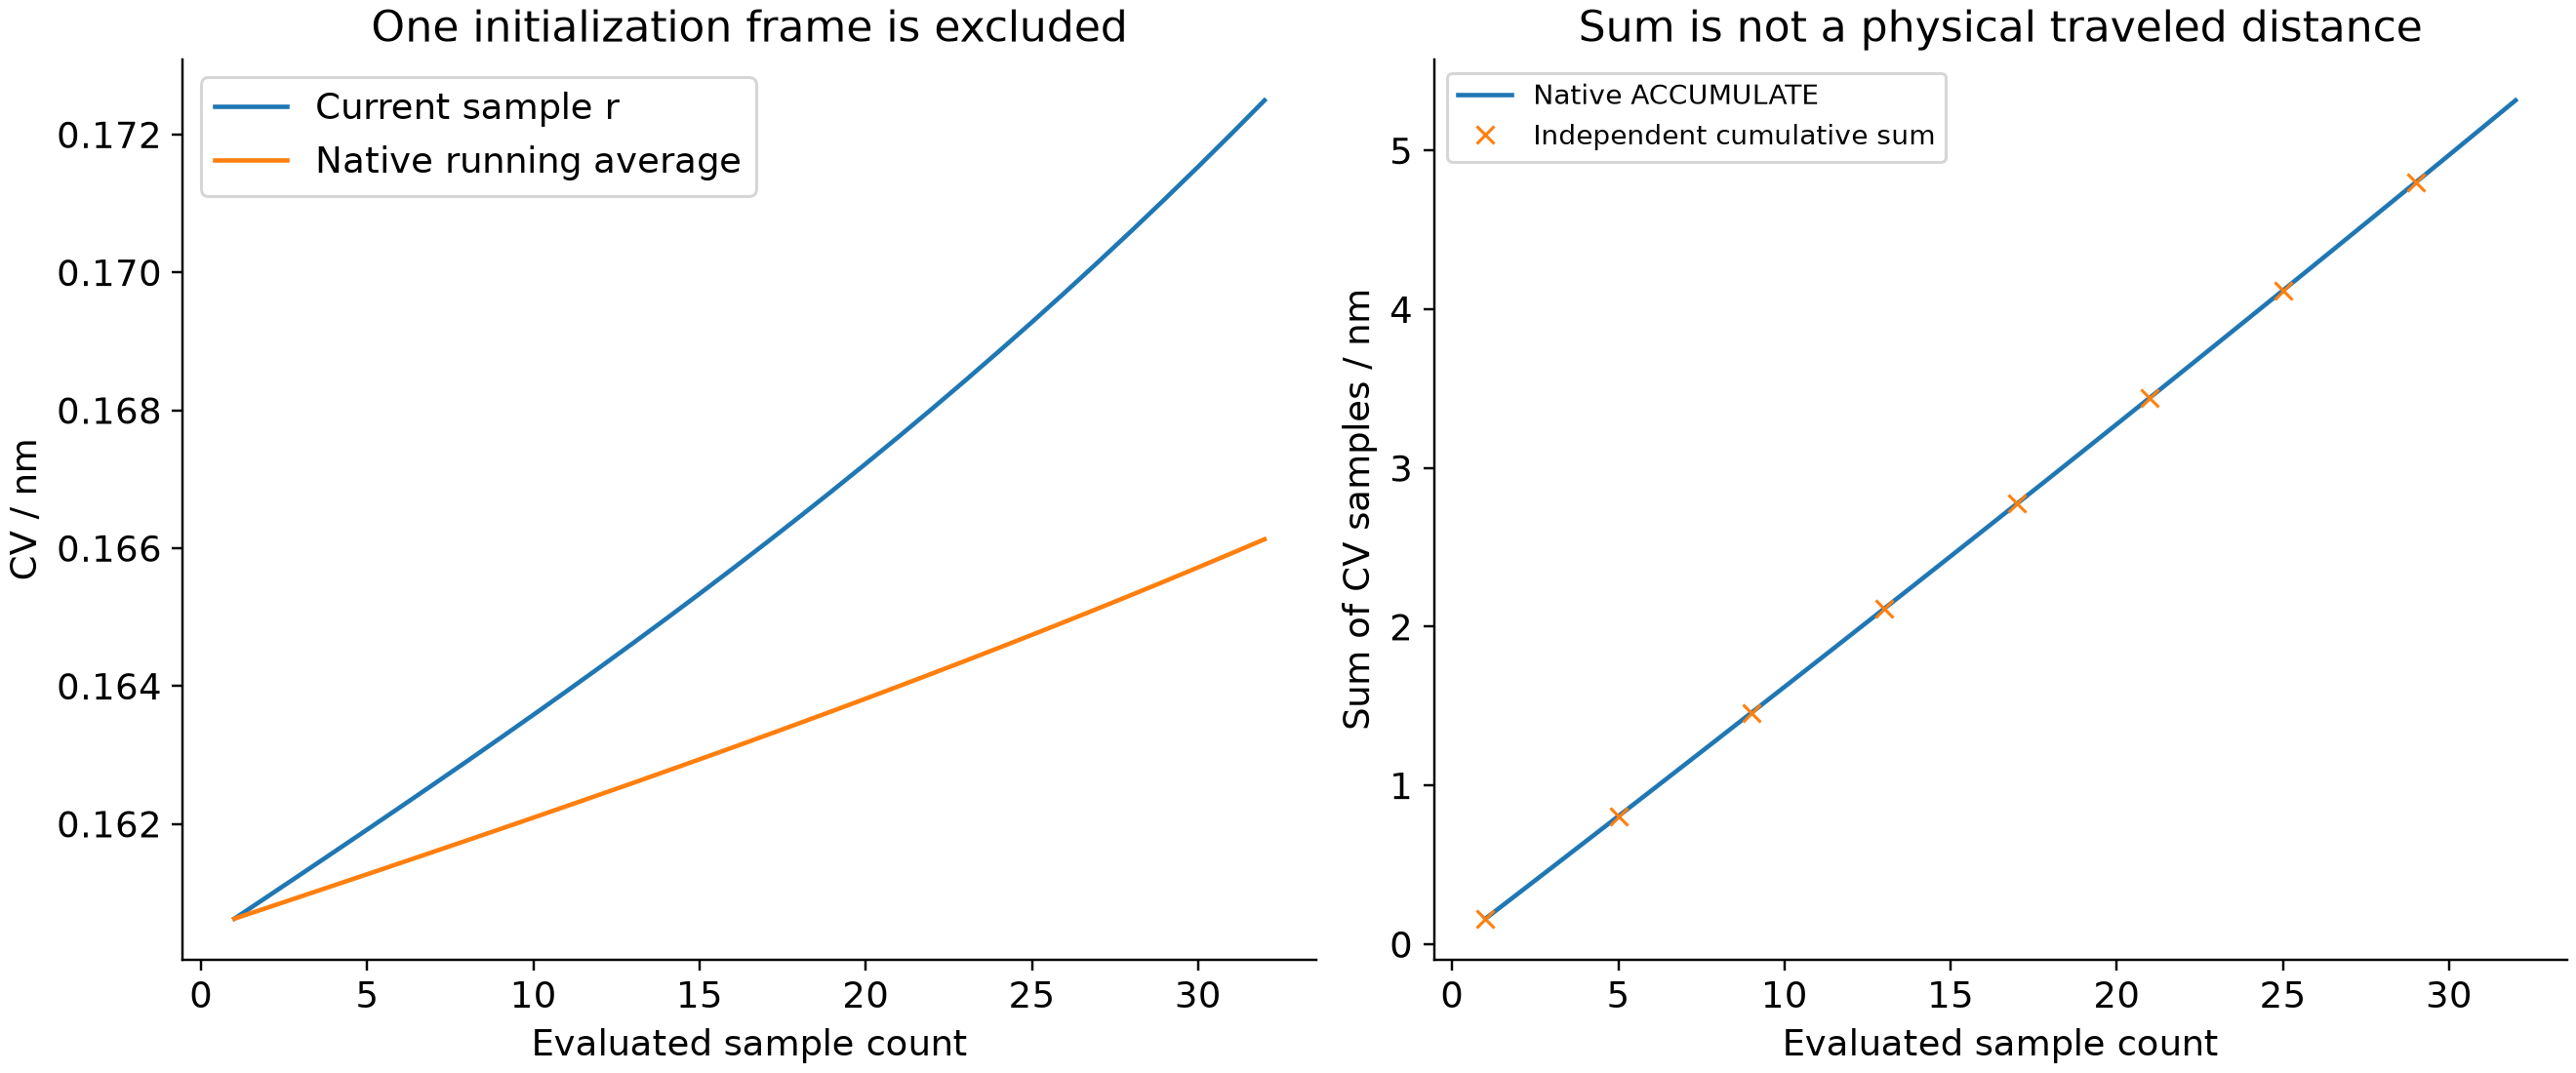
这里的构型是人工序列,不是物理MD;driver默认步进时间经UNITS TIME=ps表示,不能据此解释分子在32 ps中的真实运动。
2. 完整输入#
cat inputs/running-statistics-32samples/plumed.dat
head -n 12 inputs/running-statistics-32samples/scan.xyz
UNITS LENGTH=nm ENERGY=kj/mol TIME=ps
r: DISTANCE ATOMS=1,2 NOPBC
s: DISTANCE ATOMS=1,3 NOPBC
t: DISTANCE ATOMS=1,4 NOPBC
v: CONCATENATE ARG=r,s,t
clock: TIME
avg: AVERAGE ARG=r STRIDE=1 CLEAR=0
acc: ACCUMULATE ARG=r STRIDE=1 CLEAR=0
collected: COLLECT ARG=r STRIDE=1 CLEAR=0
PRINT ARG=r,clock,avg,acc FILE=COLVAR STRIDE=1 UPDATE_FROM=1 FMT=%.14g
DUMPVECTOR ARG=collected FILE=collected.dat STRIDE=0 PRINT_ONE_FILE FMT=%.14g
3. 为什么有初始化帧#
本次driver从时间0初始化;这些累积动作在后续步骤加入样本,时间0尚无样本时,平均值是未定义的,不能用0代替。
资料包特意在原32帧前放一帧初始化构型,因此坐标文件共33帧,真正参与时序统计的样本是时间1到32的32帧。PRINT UPDATE_FROM=1只打印有样本后的结果。开头两个坐标块相同,是本例为说明初始化而保留的安排,不代表自己轨迹都要重复第一帧。
4. 四个动作分别做什么#
| 动作 | 本例含义 |
|---|---|
TIME |
返回driver采用的时间值 |
AVERAGE ARG=r CLEAR=0 |
到当前为止的r样本均值,本例无额外权重 |
ACCUMULATE ARG=r CLEAR=0 |
到当前为止的r总和 |
COLLECT ARG=r CLEAR=0 |
保留每个r样本,最后逐项输出 |
CLEAR=0表示本例不定期清空累积数据,不是只保留最近一帧;STRIDE=1每一步采样。DUMPVECTOR STRIDE=0在结束时输出最后收集的样本向量,此例32行分别对应样本0到31。
总和的单位仍是nm,但它是样本数值相加,不是粒子走过的路程、位移或扩散系数。均值也不是概率密度,不能直接对它取对数当自由能。
5. 执行与逐行核对#
bash run.sh
bash read.sh work analysis-new
bash plot.sh analysis-new figures-new work
head reference-results/running-statistics-32samples/COLVAR
tail reference-results/running-statistics-32samples/collected.dat
cat data/PLUMED-running-statistics.csv
第一条参与统计的样本满足mean=r、sum=r;第n条满足mean=sum/n。本例32个时刻的运行平均、总和与独立累积公式最大差约4.97×10⁻¹⁴,收集后的32个值保持原样本顺序。
换成真实轨迹时,要另外明确平衡段、采样间隔、帧权重和相关时间;这篇演示的算术平均不自动提供独立样本数量或可信误差条。