
LAMMPS:均匀伸长流NVT与NPT操作
用256粒子LJ体系实际演示nvt/uef、npt/uef、流动温压和CPU及P100/V100运行方法。
阅读本篇目录
均匀伸长流会沿不同方向持续伸长或压缩晶胞。本例展示 nvt/uef、npt/uef 的完整启动、温压输出和 GPU 入口,先让用户跑通短流程,再扩展到自己的材料模型。
1. 先看数据与图片#
下载完整输入、实际输出、读取脚本和绘图脚本,保存为 example.zip:
python3 -m zipfile -e example.zip .
cd lammps-UEF
bash read.sh
bash plot.sh
reference-results 是本例实际运行结果,analysis-read 是读取后生成的数据,figures 是可重新绘制的图片。单独下载的数据:LAMMPS-UEF-data.csv。
本例使用 LAMMPS 30Sep2026。CPU 入口为 lammps/30Sep2026-8173m,Intel oneAPI 2024.2、Intel MPI、MKL,带 PLUMED 2.9.4。资料包的 CPU 模板申请一个 56 核节点,实际同时启动最多 2 个单线程 MPI 进程。
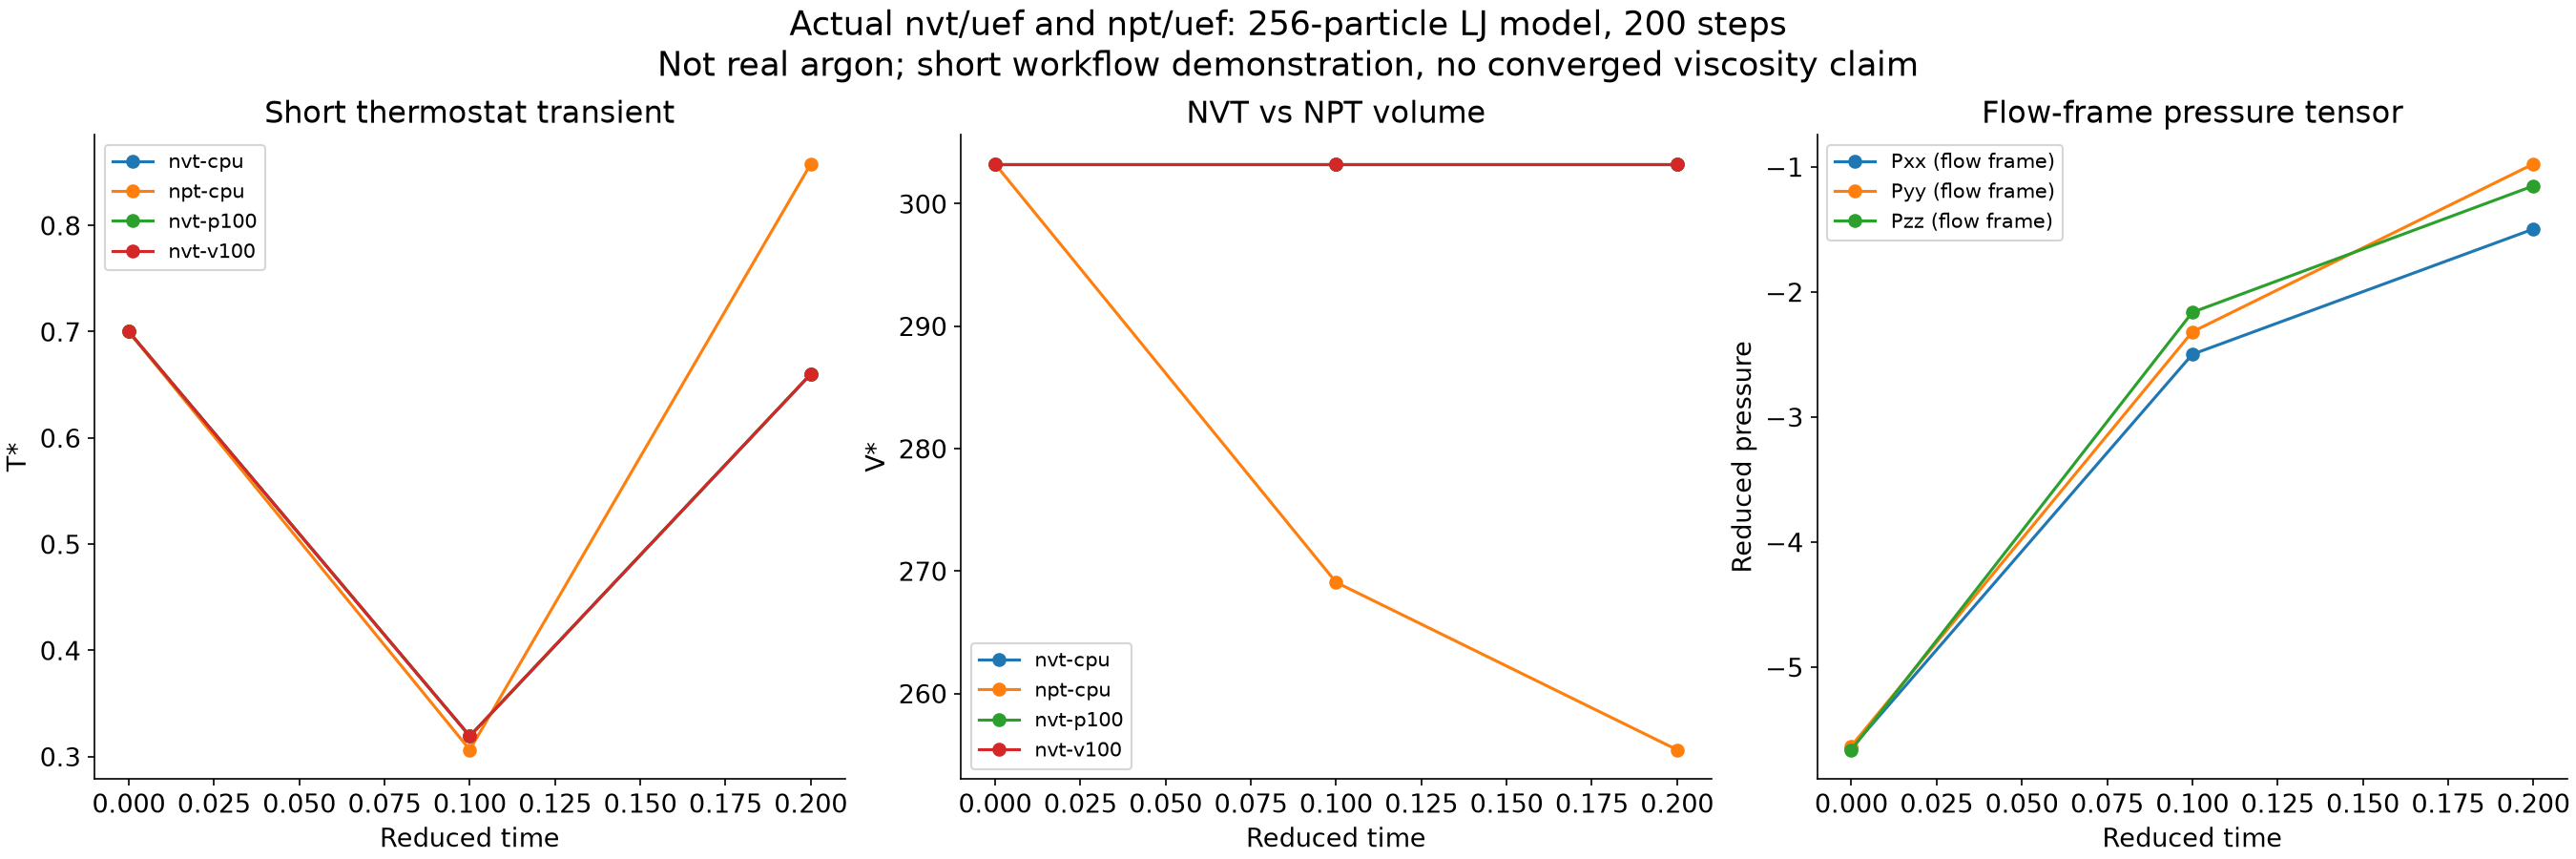
实际计算包括两个 CPU MPI 条件(NVT、NPT),以及 P100 16G、V100 16G 各一个 GPU 的 NVT 条件。GPU 使用相应 lammps/30Sep2026-p100-gpu、lammps/30Sep2026-v100-gpu 模块及 GPU package 混合精度,GCC、OpenMPI 5.0.10、CUDA 12.8。
2. 模型是什么#
体系为 FCC 排列的 256 个 LJ 粒子,质量、σ、ε均为 1,密度 0.8442,起始约化温度 0.7。这里 units lj,所有结果都是约化单位;CFG 的 Ar 只是显示标签,不能把数值直接当成真实氩的 K、Å 或 ps。
初始盒子为立方体,再转换为 triclinic 表示;步长 0.001,运行 200 步,结束时间 0.2。三个伸长率为 0.02、−0.01、−0.01,和为零。本例是短操作演示,未计算收敛的伸长黏度。
3. 完整NVT输入#
units lj
atom_style atomic
boundary p p p
lattice fcc 0.8442
region box block 0 4 0 4 0 4
create_box 1 box
create_atoms 1 box
mass 1 1
change_box all triclinic
pair_style lj/cut 2.5
pair_coeff 1 1 1 1 2.5
pair_modify shift no
neighbor 0.3 bin
neigh_modify every 1 delay 0 check yes
velocity all create 0.7 927451 mom yes rot yes dist gaussian
timestep 0.001
fix flow all nvt/uef temp 0.7 0.7 0.1 erate 0.02 -0.01
fix mom all momentum 1 linear 1 1 1
compute Tf all temp/uef
compute Pf all pressure/uef Tf
thermo 100
thermo_style custom step time vol pe ke temp c_Tf c_Pf c_Pf[1] c_Pf[2] c_Pf[3] c_Pf[4] c_Pf[5] c_Pf[6] pxx pyy pzz pxy pxz pyz lx ly lz xy xz yz
thermo_modify norm no format float %.15g
dump d all custom 100 trajectory.dump id type x y z vx vy vz fx fy fz
dump_modify d sort id format float %.14g
dump u all cfg/uef 100 flow.*.cfg mass type xs ys zs id
dump_modify u element Ar sort id format float %.14g
run 200
write_restart final.restart
temp/uef 和 pressure/uef 配套读取流动坐标系的温压。fix momentum 去掉整体线动量。这里没有同时叠加第二个积分器,也没有另外使用 fix deform 推动同一晶胞。官方 UEF 使用说明介绍了对应初始晶胞约定。
NPT 版本只替换积分 fix:
fix flow all npt/uef temp 0.7 0.7 0.1 iso 1 1 1 erate 0.02 -0.01
4. 先提交CPU,再按需选GPU#
bash submit.sh
# CPU作业结束后,只读取这两组新结果
bash read.sh work-new analysis-read nvt-cpu npt-cpu
bash plot.sh
work-new 已存在时不要重复准备覆盖,保留结果或重新解包到新目录。GPU 可复用已准备的目录,分别提交:
bash submit-gpu.sh p100
bash submit-gpu.sh v100
# CPU与两组GPU全部完成后
bash read.sh work-new analysis-read
bash plot.sh
GPU 模板每组申请一张相应型号的卡和一个 CPU 核,内部实际命令带 -sf gpu -pk gpu 1。参考输出包含设备初始化和实际设备计时;本例规模很小,不能用其耗时判断真实材料的大规模 GPU 加速比。
5. 得到哪些结果#
head -8 analysis-read/LAMMPS-UEF-data.csv
ls reference-results/nvt-cpu
每组得到 trajectory.dump、三个 flow.*.cfg、温压日志和原生 restart。NVT 的约化体积约 303.24567638,维持不变;NPT 允许整体体积调整。温度在这 200 步内仍有明显变化,不能把终点视为稳态。
资料包逐帧用独立 LJ 公式计算能量、力、动能和实验室坐标系压力,再核对流动坐标系的压力张量。GPU 混合精度对应的最大受力分量差约 1.69×10⁻⁴ 约化单位。下一篇讲两种坐标系与CFG查看。