
VTST:六版本动力学矩阵对照
用相同NH3输入实际比较5.4.4与五个6.x版本,给出模块、CPU/GPU提交方式和结果读取。
阅读本篇目录
本篇用相同 NH₃ 最小点、相同 PAW64/PBE、相同位移和电子精度,实际调用五个旧版 VASP+VTST,再与前篇 6.6.1 的原生动力学矩阵比较。它回答的是这组输入怎样在不同版本上运行,不能由此推断每个版本的所有 VTST 功能或 CPU/GPU 速度。
1. 下载并读取#
下载版本输入、实际结果、CSV 与绘图脚本,保存为 example.zip:
python3 -m zipfile -e example.zip .
cd vtst-version-dynmat
module load ase/3.29.0
bash read.sh
bash plot.sh
2. 各版本怎样选择#
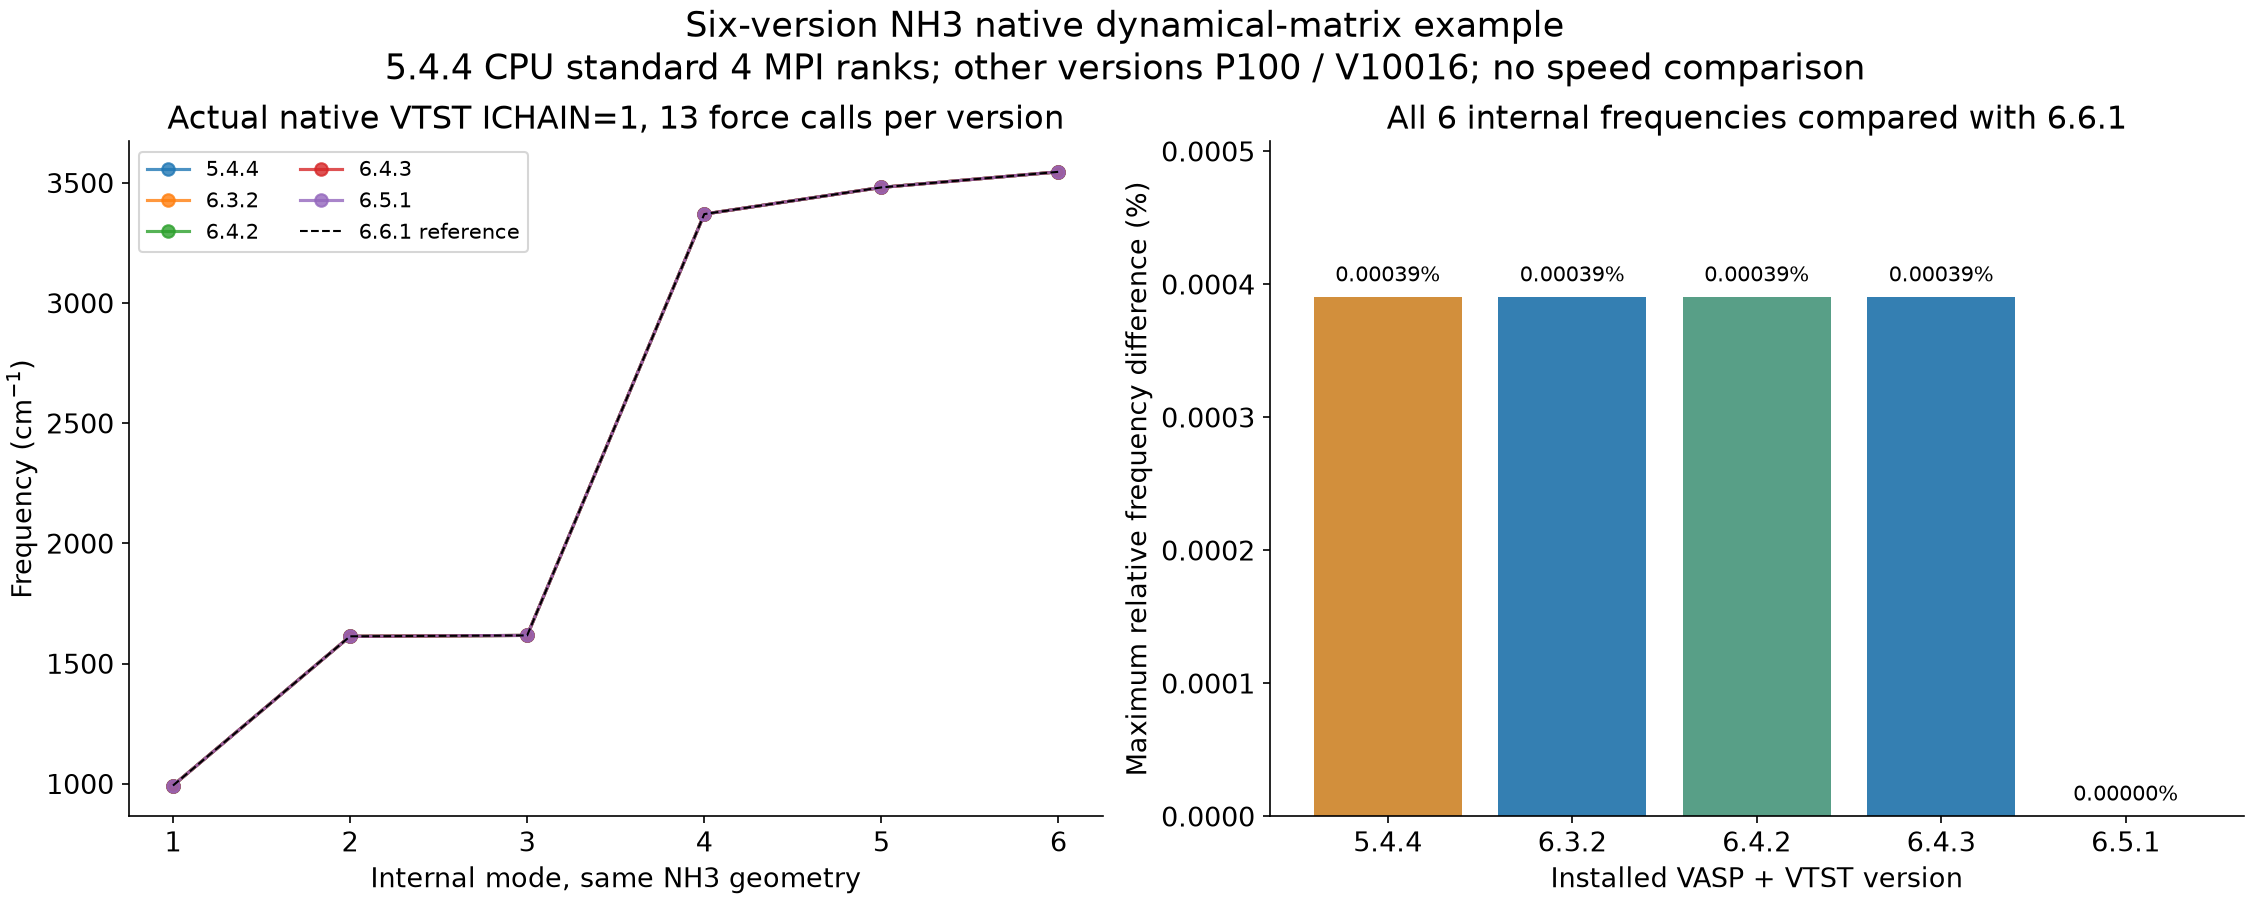
| VASP版本 | 模块 | 本例执行方式 | 最大内部频率相对差 |
|---|---|---|---|
| 5.4.4 | vasp/5.4.4-8173m-vtst |
CPU,4个MPI进程,标准版 | 0.000390% |
| 6.3.2 | vasp/6.3.2-p100-vtst |
P100,1张GPU、1个MPI进程 | 0.000390% |
| 6.4.2 | vasp/6.4.2-v100-vtst |
V10016,1张GPU、1个MPI进程 | 0.000390% |
| 6.4.3 | vasp/6.4.3-p100-vtst |
P100,1张GPU、1个MPI进程 | 0.000390% |
| 6.5.1 | vasp/6.5.1-v100-vtst |
V10016,1张GPU、1个MPI进程 | 0.000000% |
| 6.6.1 | vasp/6.6.1-p100-vtst |
P100,前篇实际结果 | 对照基准 |
相对差针对同一个 6.6.1 结构的六个内部频率逐一计算,比较的是数值结果。不同版本使用了不同 CPU/GPU 路径及 MPI 规模,本篇不将各次运行耗时作速度排名。
CPU 模块使用 Intel oneAPI 2023.2 编译环境;这些 GPU 模块使用 NVHPC 25.3、配套 OpenMPI 及 MKL 2023.2。加载一项 VASP 模块会选定对应编译环境,不需要同时加载多套编译器。
本篇 5.4.4 使用 vasp_std。请勿自行换成集群中的 vasp_gam:该 Γ 点版本在本篇这组原生 VTST 动力学矩阵输入下不能给出可用的力和模式。这个限制针对这里的版本、执行入口和输入,不作为其他普通静态任务的结论。
3. 输入保持一致#
结构与 KPOINTS 见原生动力学矩阵教程,完整文件也分别放在本包 inputs/版本号/ 中。每版都使用相同的四原子最小点、12 Å 盒、Γ 点,以及四行 0.015 0.015 0.015 的 DISPLACECAR。
cat inputs/5.4.4/POSCAR
cat inputs/5.4.4/KPOINTS
cat inputs/5.4.4/DISPLACECAR
完整 INCAR:
SYSTEM = NH3 VTST native dynamical matrix minimum
ENCUT = 550
PREC = Accurate
EDIFF = 1E-6
EDIFFG = -1E-8
IBRION = 3
POTIM = 0
ICHAIN = 1
NSW = 13
ISIF = 2
ISMEAR = 0
SIGMA = 0.05
LREAL = .FALSE.
LASPH = .TRUE.
LWAVE = .FALSE.
LCHARG = .FALSE.
NELM = 150
ALGO = Normal
ISYM = 0
NWRITE = 2
电子收敛为 1E−6;这里的 EDIFFG 只控制有限位移力收集,结构来自此前力标准为 0.02 eV/Å 的优化结果。
4. 直接提交#
bash submit.sh
squeue -u "$USER"
脚本建立 work-new/ 并提交三个作业:CPU 版 5.4.4、P100 两个版本、V100 16G 两个版本。每个 GPU 作业依次切换自己的两个模块,始终使用一张 GPU;CPU 作业申请整节点 56 核,实际使用 4 个 MPI 进程、每进程 1 线程。模板分别为 run-cpu.slurm、run-p100.slurm、run-v100.slurm。
包不包含 POTCAR,提交脚本在集群读取 H、N 的 PAW64/PBE 文件并组合。全部作业结束后:
bash read.sh work-new analysis-read
bash plot.sh
head -12 analysis-read/VTST-version-internal-frequencies.csv
若只想计算其中一个版本,可复制相应模板并保留所需的模块及那一行 compute.py 版本号,不要同时让两个作业写同一个版本目录。
5. MPI命令的区别#
在已分配的 CPU 作业内,5.4.4 的核心命令为:
module load vasp/5.4.4-8173m-vtst
export OMP_NUM_THREADS=1
mpirun -np 4 "$VASP_BIN"
GPU 版用其自己的 MPI 环境,每卡 1 个进程。本例使用如下方式,避免与 Slurm 已分配的 CPU 范围重复绑核:
module load vasp/6.3.2-p100-vtst
export OMP_NUM_THREADS=1
mpirun --bind-to none -np 1 "$VASP_BIN"
命令必须在对应的计算目录执行,目录中准备好 INCAR、POSCAR、KPOINTS、POTCAR 和 DISPLACECAR。资料包脚本会自动处理这些目录。
6. 最后检查什么#
每个版本均实际完成了参考点加 12 个位移,共 13 组力。本包检查参考结构的实际力、电子收敛、位移顺序、原生矩阵和内部模式;全部六个内部频率为正。
head -14 work-new/5.4.4/freq.dat
head -8 analysis-read/VTST-version-internal-frequencies.csv
freq.dat 是原始 12 个模式;CSV 是按真实质量和坐标去除整体平移、转动后的六个内部模式。二者不要混用,处理方法见整体模式与频率检查。
若需要读参考能量,请核对 OUTCAR 的 TOTEN 与 OSZICAR 的 F=;5.4.4 这类 VTST 控制流程中,XML 后写出的能量字段不能直接替代这些实际电子能量。振动矩阵在本包始终从 HIPREC TOTAL-FORCE 提取。
改成自己的体系后,仍需检查结构、赝势、位移及科学结果的稳定性;同一份小分子输入的版本对照不代表任意体系都可以直接沿用全部参数。