
CREST:压缩采样的步骤与输出
讲清compress的试运行、九组短采样、后续优化和文件读取,区分边界参数、真实温度及构象能量。
阅读本篇目录
本篇从准备结构、提交采样、读取轨迹,到查看最终构象,完整走一遍 --compress。初始结构和与局部优化的对照见前篇。
1. 解包并读取#
下载完整输入、实际结果、CSV和读取绘图脚本,保存为 example.zip:
python3 -m zipfile -e example.zip .
cd crest-compression-trialopt
bash read.sh
bash plot.sh
默认读取 reference-results,生成 analysis-read 和 figures。数据也可单独下载:CREST-compression-energies.csv、CREST-compression-frames.csv。
本例使用独立 CREST 3.0.3,GNU Fortran 与 MKL 编译,配套 xTB 6.7.1。需要重算且尚未建立个人 3.0.3 程序时,在已分配的 CPU 作业内先运行 bash build-private.sh;首次构建需访问源码仓库。程序放在 ~/.local/ys-crest-tools/bin/crest,其他本专题使用此入口的教程可以共用。已有该入口则直接使用。CPU 提交模板申请 56 核整节点,实际使用 2 线程。
2. 工作流具体顺序#
先准备中性水二聚体 input.xyz;随后提交 --compress。程序完成边界设置和试运行,再执行多组短采样,收集候选并做几何优化,最后排序、去重,写出较低能结构和集合文件。
bash submit.sh
# 等待Slurm作业完成
bash read.sh work-new analysis-read
bash plot.sh
本包同时提交一个试优化对照,两个方法在各自目录运行。不要把试优化中的 crestopt.log.xyz 当作压缩搜索的轨迹。
3. 0.2 ps到底控制哪里#
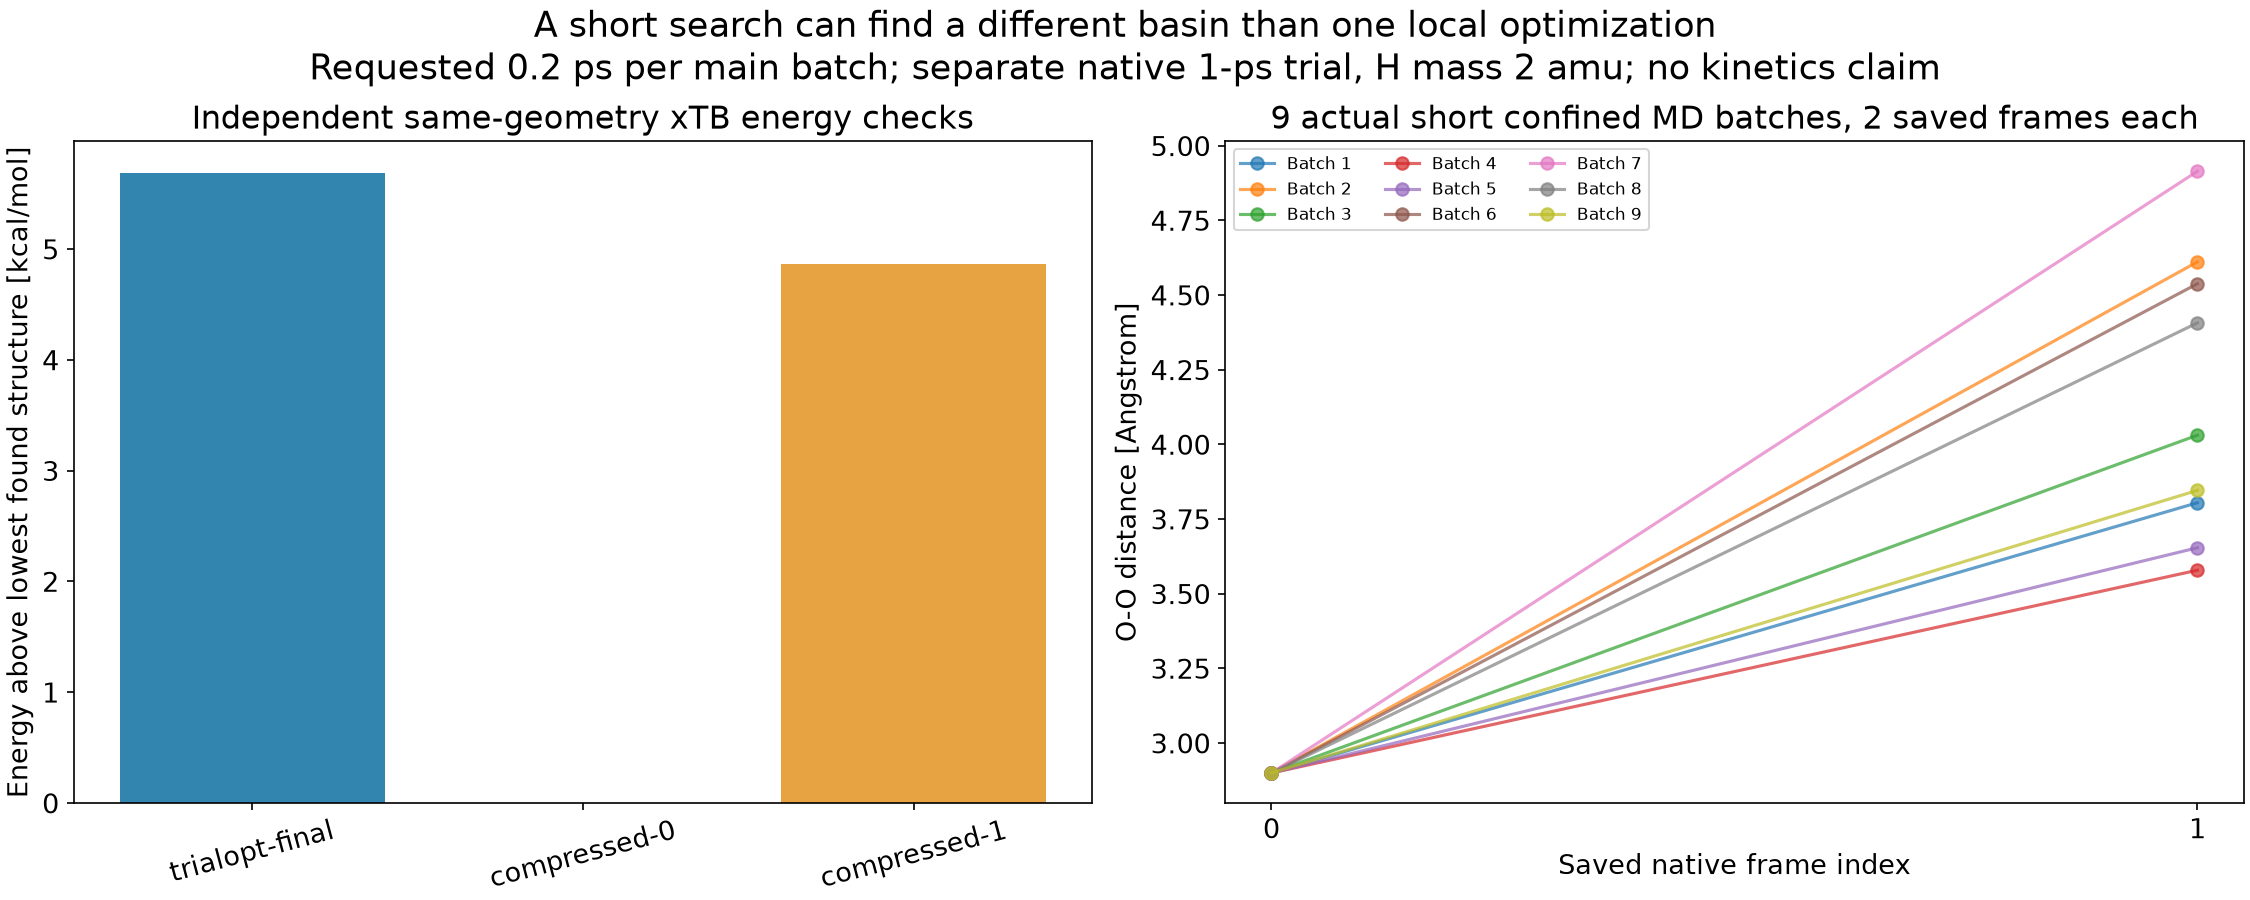
本包命令设置 --mdlen 0.2。实际原生输出包含单独的1 ps试运行,以及 9组各0.2 ps的主采样。不能把整个流程的总采样长度说成只有0.2 ps。
grep -E 'Trial MTD|MD time|dt /fs|max steps|dumpstep|H atoms' reference-results/compress-02ps/METADYN1/xtb.out
grep -E 'Trial MTD|Estimated runtime' reference-results/compress-02ps/native.log
主采样实际步长1 fs、每组200步,轨迹间隔100 fs,因此本次每组只保存两帧。图中使用保存帧序号;两帧不足以分析反应速率或可靠的时间相关函数。
本次搜索使用氢原子动力学质量2 amu。它会影响运动过程,因此更不应直接把这些短搜索轨迹当成真实同位素条件下的动力学结论。
4. 6000 K是什么温度#
cat reference-results/compress-02ps/rcontrol
其中球形 logfermi 半径约8.345 Bohr,temp=6000 是边界势参数;主采样的实际温控设置为300 K。二者含义不同。人工边界与RMSD偏置也不能直接换算成实验静水压力。
5. 最后看哪些文件#
| 文件 | 用途 |
|---|---|
crest_best.xyz |
本次找到的较低能结构 |
crest_conformers.xyz |
排序去重后的候选构象 |
METADYN1/xtb.trj等 |
各组实际采样保存的帧 |
METADYN1/xtb.out等 |
该组实际步长、温度和输出间隔 |
rcontrol |
人工边界设置 |
CREST-compression-energies.csv |
最终候选与独立单点能量 |
head -10 reference-results/compress-02ps/crest_conformers.xyz
head -8 analysis-read/CREST-compression-frames.csv
head -8 analysis-read/CREST-compression-energies.csv
采样轨迹中的原生能量读数与最终无搜索偏置的构象能量用途不同。比较候选稳定性时,优先使用一致方法下的最终优化/单点结果;不要把包含搜索过程的读数直接当作平衡自由能。
本次得到两个候选;随机采样重算后数量和几何可能变化。资料包绘图脚本按实际集合读取,候选数不是必须重复出现的固定答案。
参数参考:该固定版本附带的CREST命令手册。具体操作和结果见上面的实际输入。