
CREST:甲酸酸碱集合自动准备
先优化甲酸和甲酸根,再用abprep自动生成自由能集合,避免手工拼接校正。
阅读本篇目录
已有酸、碱结构时,可以让 --abprep 自动准备集合文件,再交给pKa入口。本例实际计算甲酸与甲酸根,演示从坐标到结果的文件传递流程。
本例只有一个酸结构和一个碱结构;pKa约3.40是GFN2/ALPB水模型的估算值,不是实验数据,也没有进行完整构象采样。
1. 查看实际结构与结果#
下载完整输入、实际结果和读取绘图程序,保存为 example.zip:
python3 -m zipfile -e example.zip .
cd crest-formic-abprep
bash read.sh
bash plot.sh
默认读取附带结果,在 analysis-read 和 figures 生成数据与图片,不重新执行计算。
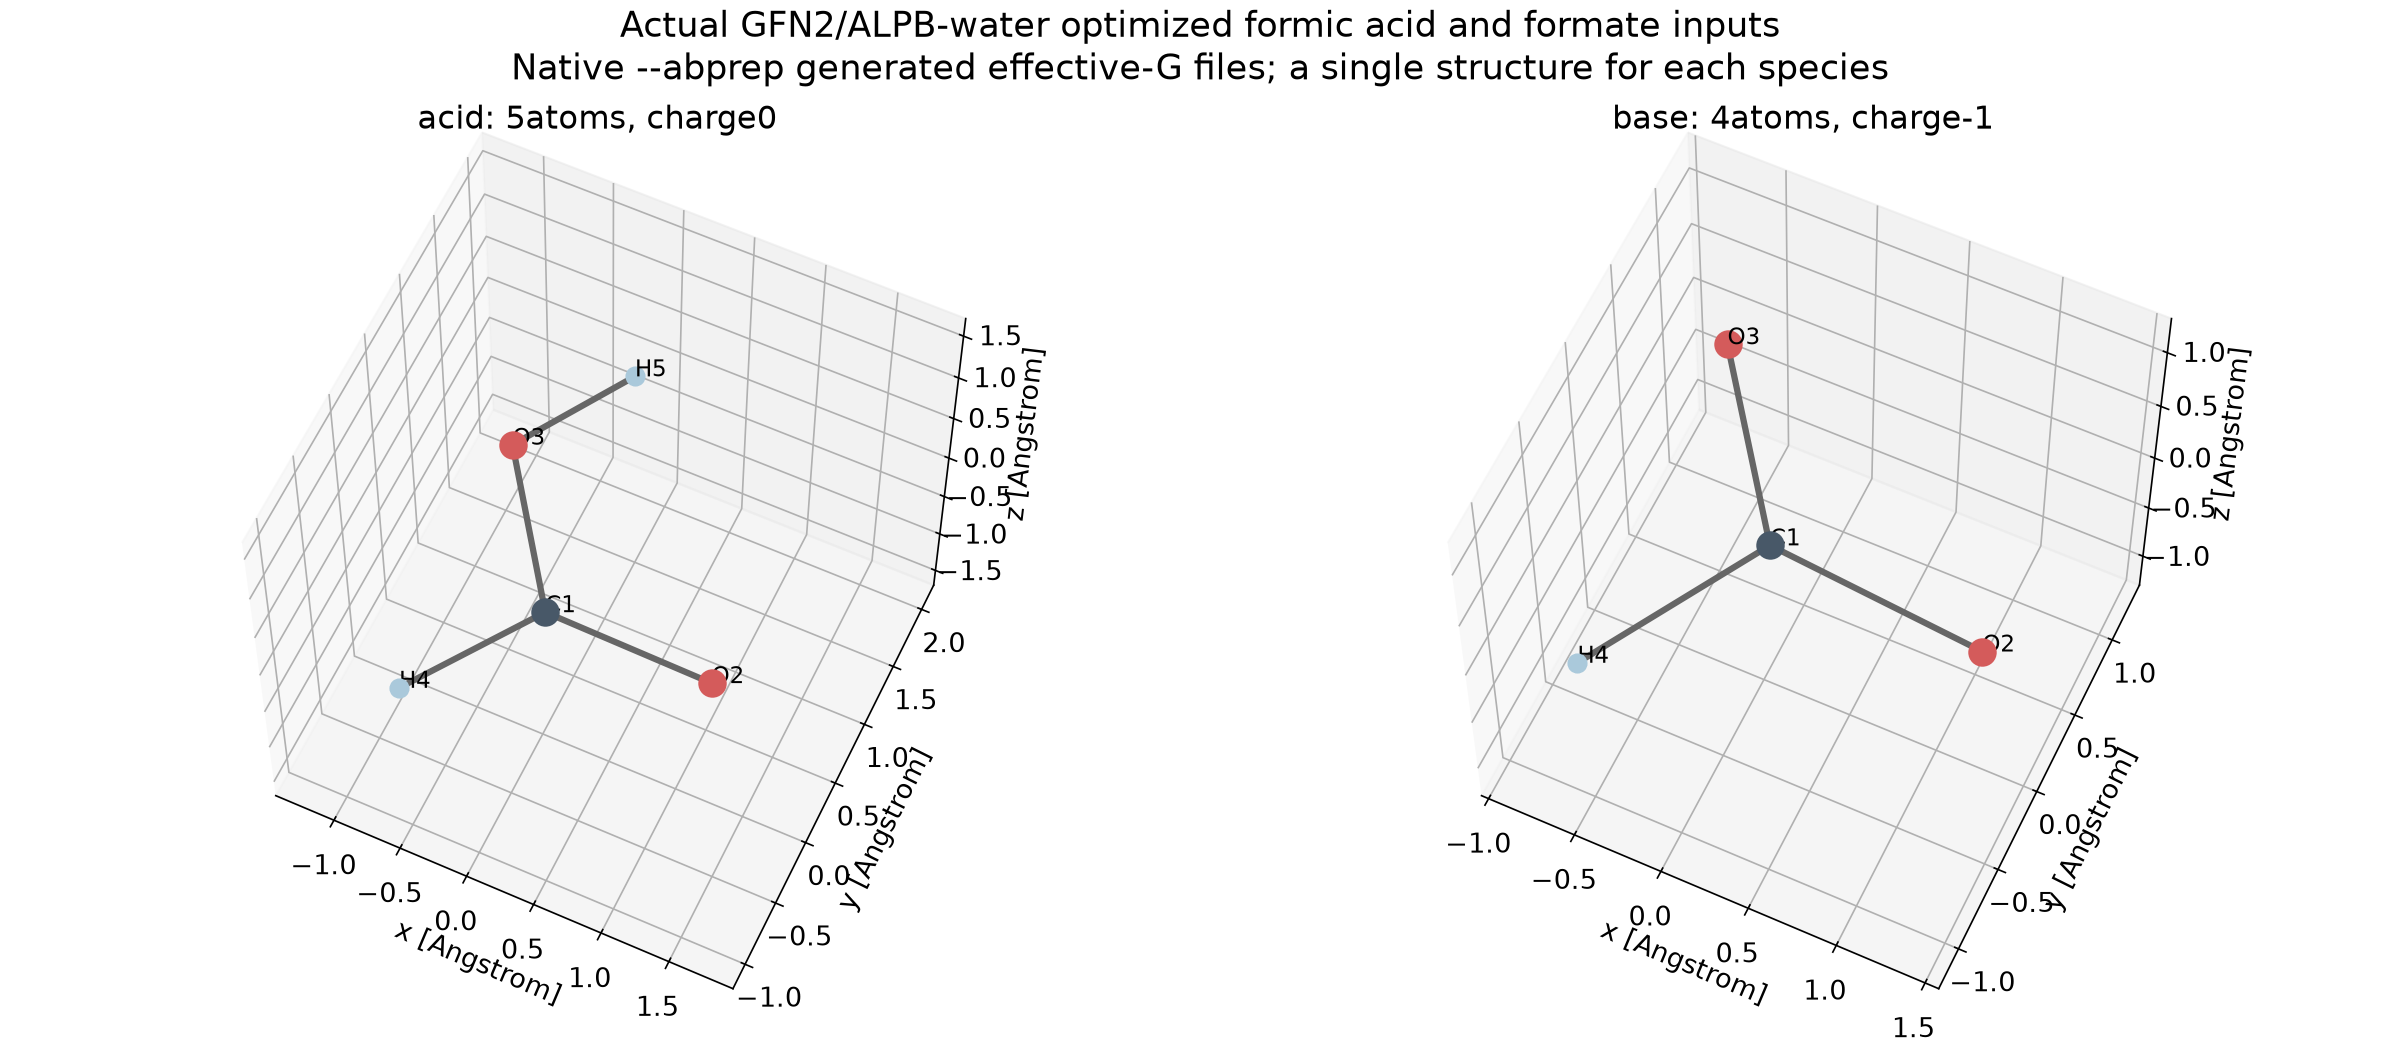
甲酸5原子、电荷0;甲酸根4原子、电荷−1。两者保持共同原子的编号,酸比碱多一个酸性H。下载分项CSV和pKa账目CSV。
2. 准备两份XYZ#
本例初始甲酸为:
5
Own initial formic acid geometry
C 0 0 0
O 1.20 0 0
O -0.67 1.10 0
H -0.55 -0.94 0
H -0.20 1.94 0
甲酸根为:
4
Own initial formate geometry
C 0 0 0
O 1.20 0 0
O -0.67 1.10 0
H -0.55 -0.94 0
这里使用可解释的小分子初始几何。对自己的结构,先确认脱去的是哪个H、总电荷怎样变化,以及酸碱共同原子是否对应,不能简单删除任意一个H。
3. 分别优化#
软件为独立CREST 3.0.3(GNU Fortran、MKL)与xTB 6.7.1。首次使用该个人CREST入口,可在分配的CPU作业内运行 bash build-private.sh;已建好本专题入口可共用。
以下命令在已分配CPU资源中运行,酸与碱各放独立目录:
module load xtb/6.7.1
# acid-opt目录,电荷0
xtb input.xyz --gfn 2 --alpb water --chrg 0 \
  --opt vtight --acc 0.1 --parallel 2 > optimize.log
# base-opt目录,电荷-1
xtb input.xyz --gfn 2 --alpb water --chrg -1 \
  --opt vtight --acc 0.1 --parallel 2 > optimize.log
优化结果在各自 xtbopt.xyz,分别复制为下一步的 acid.xyz、base.xyz。不要把初始结构、优化后结构和能量标签混用。
4. 自动生成G集合#
在新的工作目录准备两份优化结构,以及一份酸结构 input.xyz:
cp ../acid-opt/xtbopt.xyz acid.xyz
cp ../base-opt/xtbopt.xyz base.xyz
cp acid.xyz input.xyz
~/.local/ys-crest-tools/bin/crest input.xyz \
  --abprep acid.xyz base.xyz --gfn2 --alpb water \
  --chrg 0 --T 2 --keepdir
ls G_acid.xyz G_base.xyz
该路径内部使用xTB的 --bhess 单点Hessian/SPH流程计算相应热化学校正,不应把它当成普通无偏Hessian的同义命令。官方含义见xTB频率计算说明。本例输入已先优化,独立读取也按相同SPH方法核对。
5. 读取pKa#
~/.local/ys-crest-tools/bin/crest input.xyz --pka 5 \
  --pkaensemble G_acid.xyz G_base.xyz --gfn2 --T 1
本次原生输出约 3.40,独立代入同一经验多项式约 3.39575,与原生显示精度一致。--pka 5 中的5原本用于指定酸结构中第5个酸性H。本例已经提供酸、碱的G集合,重读时不会再删除H或重复计算自由能;5不是预设的pKa值。
整包已封装以上步骤:
bash submit.sh
# 作业完成后
bash read.sh work-new analysis-read
bash plot.sh
CPU模板申请56核整节点,实际使用2线程。G文件中校正的含义见酸碱自由能集合如何读。