
CREST:聚类代表与后续计算
查看实际选出的三个七碳链结构,说明编号、能量与后续统一优化的操作。
阅读本篇目录
聚类的目的通常是减少下一步要算的结构数量。选出的文件还需要检查原子顺序、结构连接关系和后续计算方法,不能直接把簇的数量当成热力学状态数。
1. 查看本次三个代表#
下载完整输入、实际结果与读取绘图脚本,保存为 example.zip:
python3 -m zipfile -e example.zip .
cd crest-heptane-clusters
bash read.sh
bash plot.sh
这两步读取附带的实际结果,生成 analysis-read 数据与 figures 图片;不会重新计算。要换成自己的输入,请先阅读下面的流程。
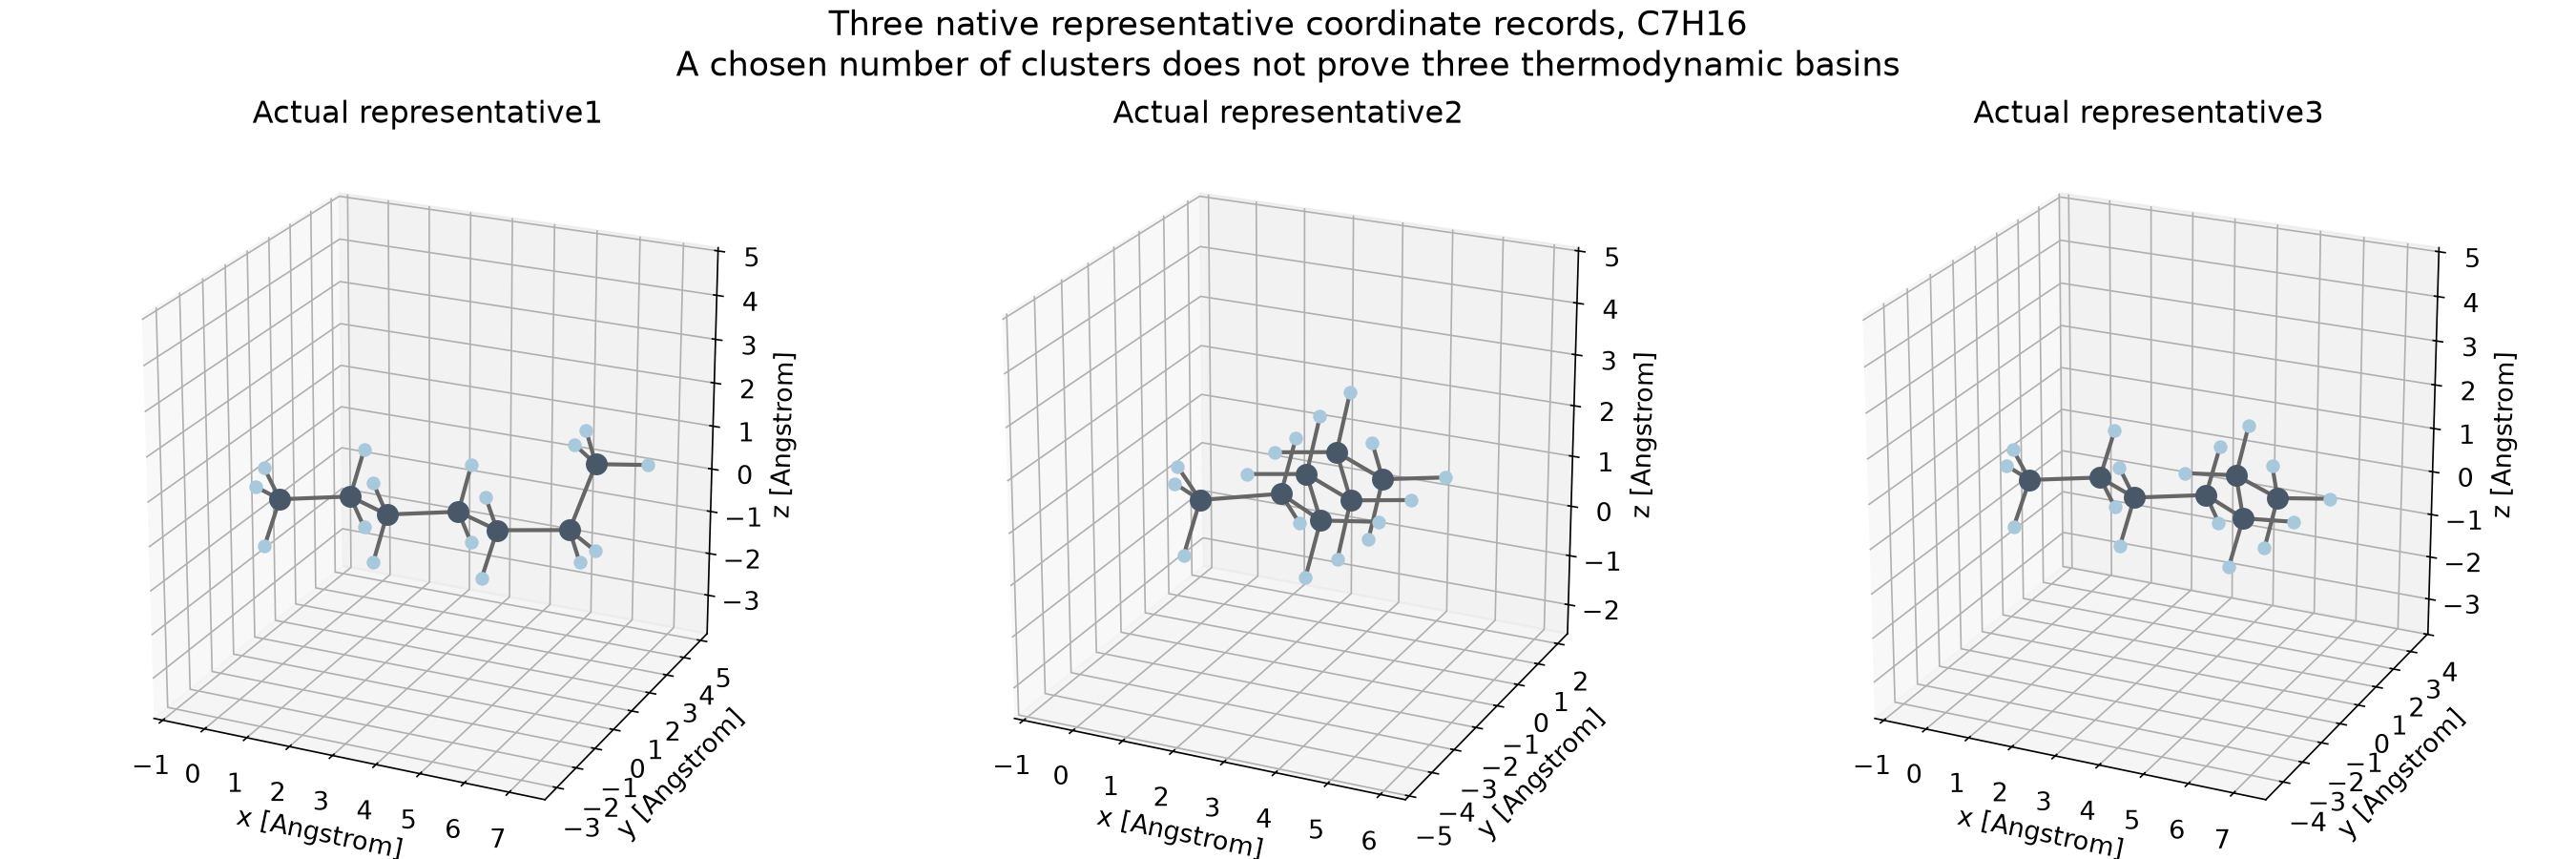
本次代表对应输入集合的第 8、3、7 条记录,能量约 −3.29018654、−3.29018651、−3.29016050 Eh。文件中坐标和能量与相应输入记录保持一致。
2. 导出各代表文件#
module load ase/3.29.0
python3 - <<'PY'
from pathlib import Path
from ase.io import read, write
frames = read('reference-results/cluster-corrected/crest_clustered.xyz', index=':')
Path('selected').mkdir(exist_ok=True)
for i, atoms in enumerate(frames, 1):
    write(f'selected/representative-{i}.xyz', atoms)
PY
ls selected
可使用集群 ase/3.29.0 环境,或资料包读取脚本使用的ASE Python。导出几何后,原集合里的能量注释仍应作为单独数据保留,不能假设任意XYZ转换器都会复制其含义。
3. 准备更高层级的计算#
下一步可以对3条代表统一做GFN2-xTB优化,或者生成ORCA等软件输入。以下是分配到CPU资源后对其中一条运行GFN2优化的命令模板:
module load xtb/6.7.1
cd selected
mkdir representative-1-gfn2
cp representative-1.xyz representative-1-gfn2/input.xyz
cd representative-1-gfn2
xtb input.xyz --gfn 2 --opt --parallel 2 > optimize.log
这段是迁移到下一计算层级的操作模板,本篇报告的数据仍为前述GFN-FF与聚类结果,不包含这次GFN2优化的新结果。对所有代表使用一致的方法、总电荷与未配对电子数,优化后再重新排序、去重和计算需要的性质。
4. 哪些数字不应直接解释为占比#
本例9条候选是人为构造的教学集合,不是充分采样后的平衡分布;指定3簇也不证明恰好存在3个热力学盆地。某一簇中记录多,可能只是初始构造重复较多,不能据此得出该构象占比高。
需要温度依赖的构象权重时,先完成更充分的采样和统一能量/频率处理,再参考集合RRHO与权重。
需要根据你的体系选择资源?联系讨论计算需求。实际可用软件与权限,以当前账户和运行环境为准。