
CREST:低成本搜索与GFN2精化
用乙醇实际运行GFN0、GFN1、GFN-FF搜索后GFN2再优化,给出提交、最终文件与能量修正。
阅读本篇目录
先用低成本方法产生结构集合,再用GFN2重新优化,是控制构象搜索成本的一种思路。本例实际运行三套基础方法:GFN0、GFN1和GFN-FF,后续均用GFN2精化。重点是接好文件流程,最后比较同一精化方法的结果。
1. 下载并看最终结果#
下载完整输入、实际原生输出与读取绘图程序,保存为 example.zip:
python3 -m zipfile -e example.zip .
cd crest-hybrid-refinement
bash read.sh
bash plot.sh
默认读取附带结果,数据在 analysis-read,图片在 figures,不会重新计算。
2. 输入是同一个乙醇#
  9
        -11.39433910
 C          1.2750289644       -0.2515241684        0.0158011367
 C         -0.0145443659        0.5611903010       -0.0327704172
 O         -1.1686977989       -0.2414759555        0.0562651005
 H         -1.1386480109       -0.9029780262       -0.6441512671
 H         -0.0686900525        1.2383402554        0.8227749423
 H         -0.0396518140        1.1636698038       -0.9534096406
 H          2.1345689321        0.4129462594        0.0084166343
 H          1.3022599330       -0.8537018392        0.9208186794
 H          1.3412432661       -0.9152586670       -0.8453575975
中性、闭壳层C₂H₆O,9原子。环境为个人独立CREST 3.0.3,GNU Fortran与MKL构建,外部xTB 6.7.1。首次可在已分配CPU作业内执行 bash build-private.sh,已有本专题个人入口可共用。
3. 先用最简单的整包入口#
bash submit.sh
模板通过Slurm申请CPU整节点,原生任务使用2线程,三种基础方法依次运行。程序不仅执行搜索与再优化,还会从实际优化日志读取正确的最终能量,再整理输出集合。
实际GFN-FF→GFN2命令为:
~/.local/ys-crest-tools/bin/crest input.xyz \
  --v2 --legacy --gfn2@gfnff --quick \
  --mdlen 0.1 --mddump 10 --T 2 --keepdir
另外两组将 --gfn2@gfnff 改为 --gfn2@gfn0 或 --gfn2@gfn1。这些组合在本版本使用旧式外部xTB路径,因此保留 --legacy。
4. 顺着日志看两个阶段#
grep -E 'MTD|Reoptimization of entire CRE' \
  reference-results/gfnff/native.log
ls reference-results/gfnff/PROP/TMPCONF1
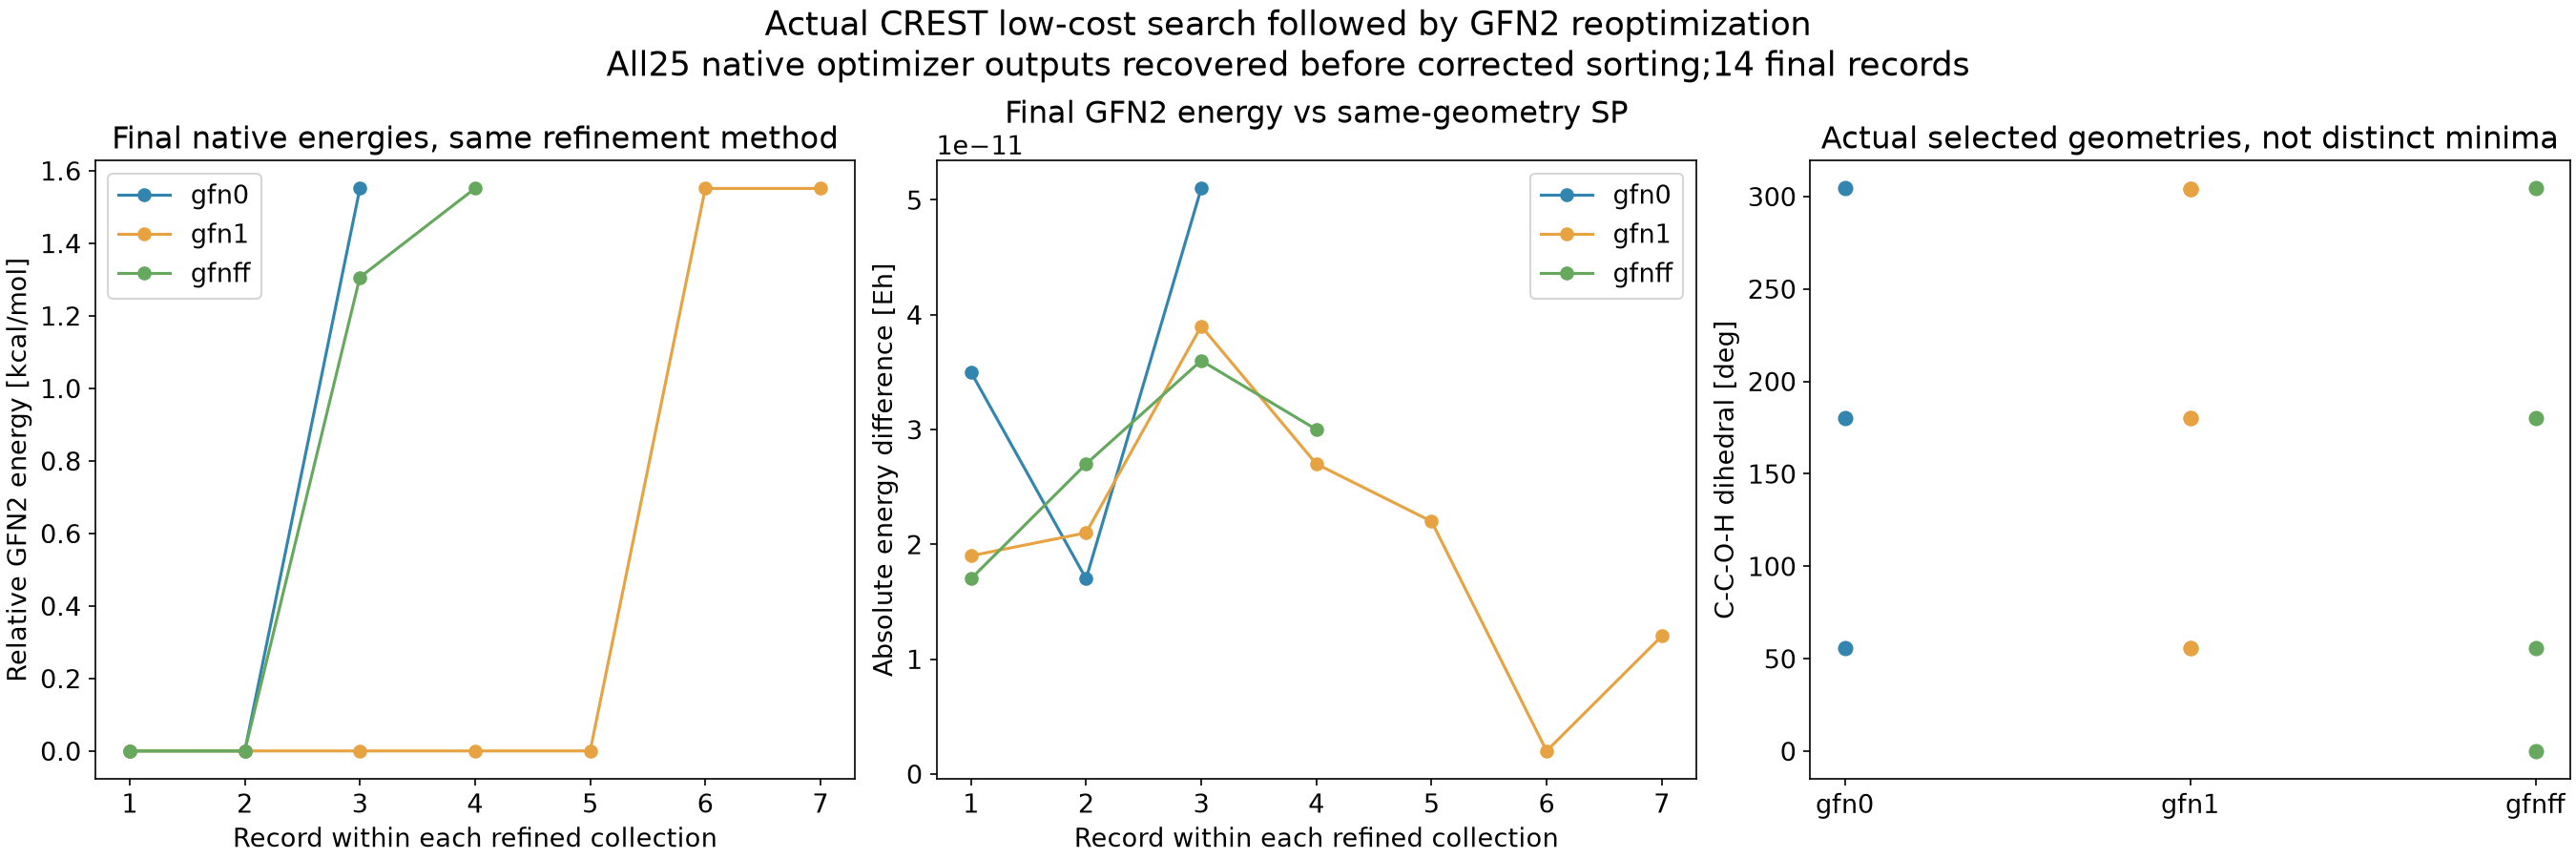
先在基础方法上搜索,然后在 PROP/TMPCONF* 中逐条进行GFN2优化。本次三组分别有 12、7、6 份原生精化输出,共25份;整理后分别保留3、7、4条记录。记录数不能直接当成不同稳定构象或不同极小值的数量,还要结合去重标准、连接关系与频率判断。
5. 最后读取哪个集合#
本次维护版的原始 crest_reopt.xyz 曾将优化前能量写入注释,而坐标已更新。资料包保留这些原始文件,并自动从每份 xtb.out 的最后一条 TOTAL ENERGY 和对应 xtbopt.xyz 重建集合,再调用CREGEN。
head work-new/final-gfnff/corrected.xyz.sorted
bash read.sh work-new analysis-read
bash plot.sh
因此本包最终使用 final-*/corrected.xyz.sorted。不要把基础搜索的 crest_conformers.xyz 当成最终GFN2精化结果,也不要直接沿用存在旧标签问题的集合做能量排序。处理细节见最终能量与排序。
6. 怎样比较这三组结果#
下载最终精化CSV。本次最终标签与相同几何的独立GFN2单点最大差约 5.1×10⁻¹¹ Eh。
比较时使用同一GFN2精化方法的相对能量,不将GFN0、GFN1和GFN-FF的绝对能量混在一起排序。这些都是小体系短搜索,不能由一次结果推断某种方法对所有分子都更快、更完整或一定找到更低能构象。