
MACE的cuEquivariance格式转换实操
实际执行e3nn与cuEquivariance格式的双向转换,检查恢复后的能量、力和应力,并说明所用CUDA包的硬件条件。
阅读本篇目录
MACE提供mace_e3nn_cueq和mace_cueq_to_e3nn两个转换工具。本篇演示CPU上的模型格式往返:原模型→cuEquivariance格式→恢复为e3nn,再比较恢复后的完整能量、原子力与应力。
格式转换成功与GPU加速可用是两件事。 这里没有在P100或V100上运行cuEquivariance加速;所检查的0.7.0 CUDA预编译包没有这两种卡所需的二进制目标,详见后面的具体条件。
1 下载并读取已有结果#
python3 -m zipfile -e mace-cueq-format-conversion-wave965-*.zip .
cd mace-cueq-format-conversion
bash read.sh
bash plot.sh
默认读取已完成结果,不重新转换或运行模型。模型是此前实际训练的Si小模型,测试含4个Si₂与4个Si₈结构;它不是通用材料基础势。
版本为MACE0.3.16、PyTorch2.8.0/CUDA12.6、e3nn0.4.4,cuEquivariance相关包固定为0.7.0。CPU转换使用前端的PyTorch实现路径,不把它称为CUDA内核加速。
2 在个人目录准备依赖#
需要重新转换时,先执行:
bash setup.sh
脚本把匹配版本安装到当前解压目录的.cueq-deps,不修改公共MACE环境。安装需要可访问对应的Python包源;已有这个目录时保留原环境,使用新解压目录。
依赖安装与模型计算是两个步骤,bash read.sh读取已附数值不需要安装这些转换依赖。
3 执行两个原生转换命令#
在计算脚本已经准备好MACE环境和上述个人依赖后,关键命令为:
mace_e3nn_cueq base.model --device cpu --return_model --output_model cueq.pt
mace_cueq_to_e3nn base.cueq.pt --device cpu --return_model --output_model restored.pt
这个版本的--return_model参数名容易误解:命令行使用这个开关时,实际触发保存文件。本例输出依次为:
base.cueq.pt
base.cueq.restored.pt
工具会在输出名称前加输入模型的基础文件名,因此第二个输出不是简单的restored.pt。不要在没有检查实际文件名时直接把下一步输入写错。
资料包把环境与目录准备封装为一个CPU任务,根目录提交即可:
sbatch submit.sh
CPU分区按56核整节点申请和计费,实际转换单线程;新文件位于work-new/。脚本保留已有目录,不覆盖旧结果。
4 往返之后数值有没有变化#
实际完成两个转换后,检查恢复模型的全部保存状态,并在8个测试结构上计算完整能量、所有原子力分量和3×3应力。它们与此前保存的原模型结果在以下范围内一致:
| 对照量 | 本例比较范围 |
|---|---|
| 保存状态中的数值张量 | 10⁻¹² |
| 总能量 | 10⁻⁷ eV |
| 原子力 | 10⁻⁶ eV/Å |
| 应力 | 10⁻⁷ eV/ų |
布尔状态直接检查相等,不对布尔值作减法。这些数值说明本例的格式往返保持模型行为,不是模型相对DFT的误差,也不是性能比较。
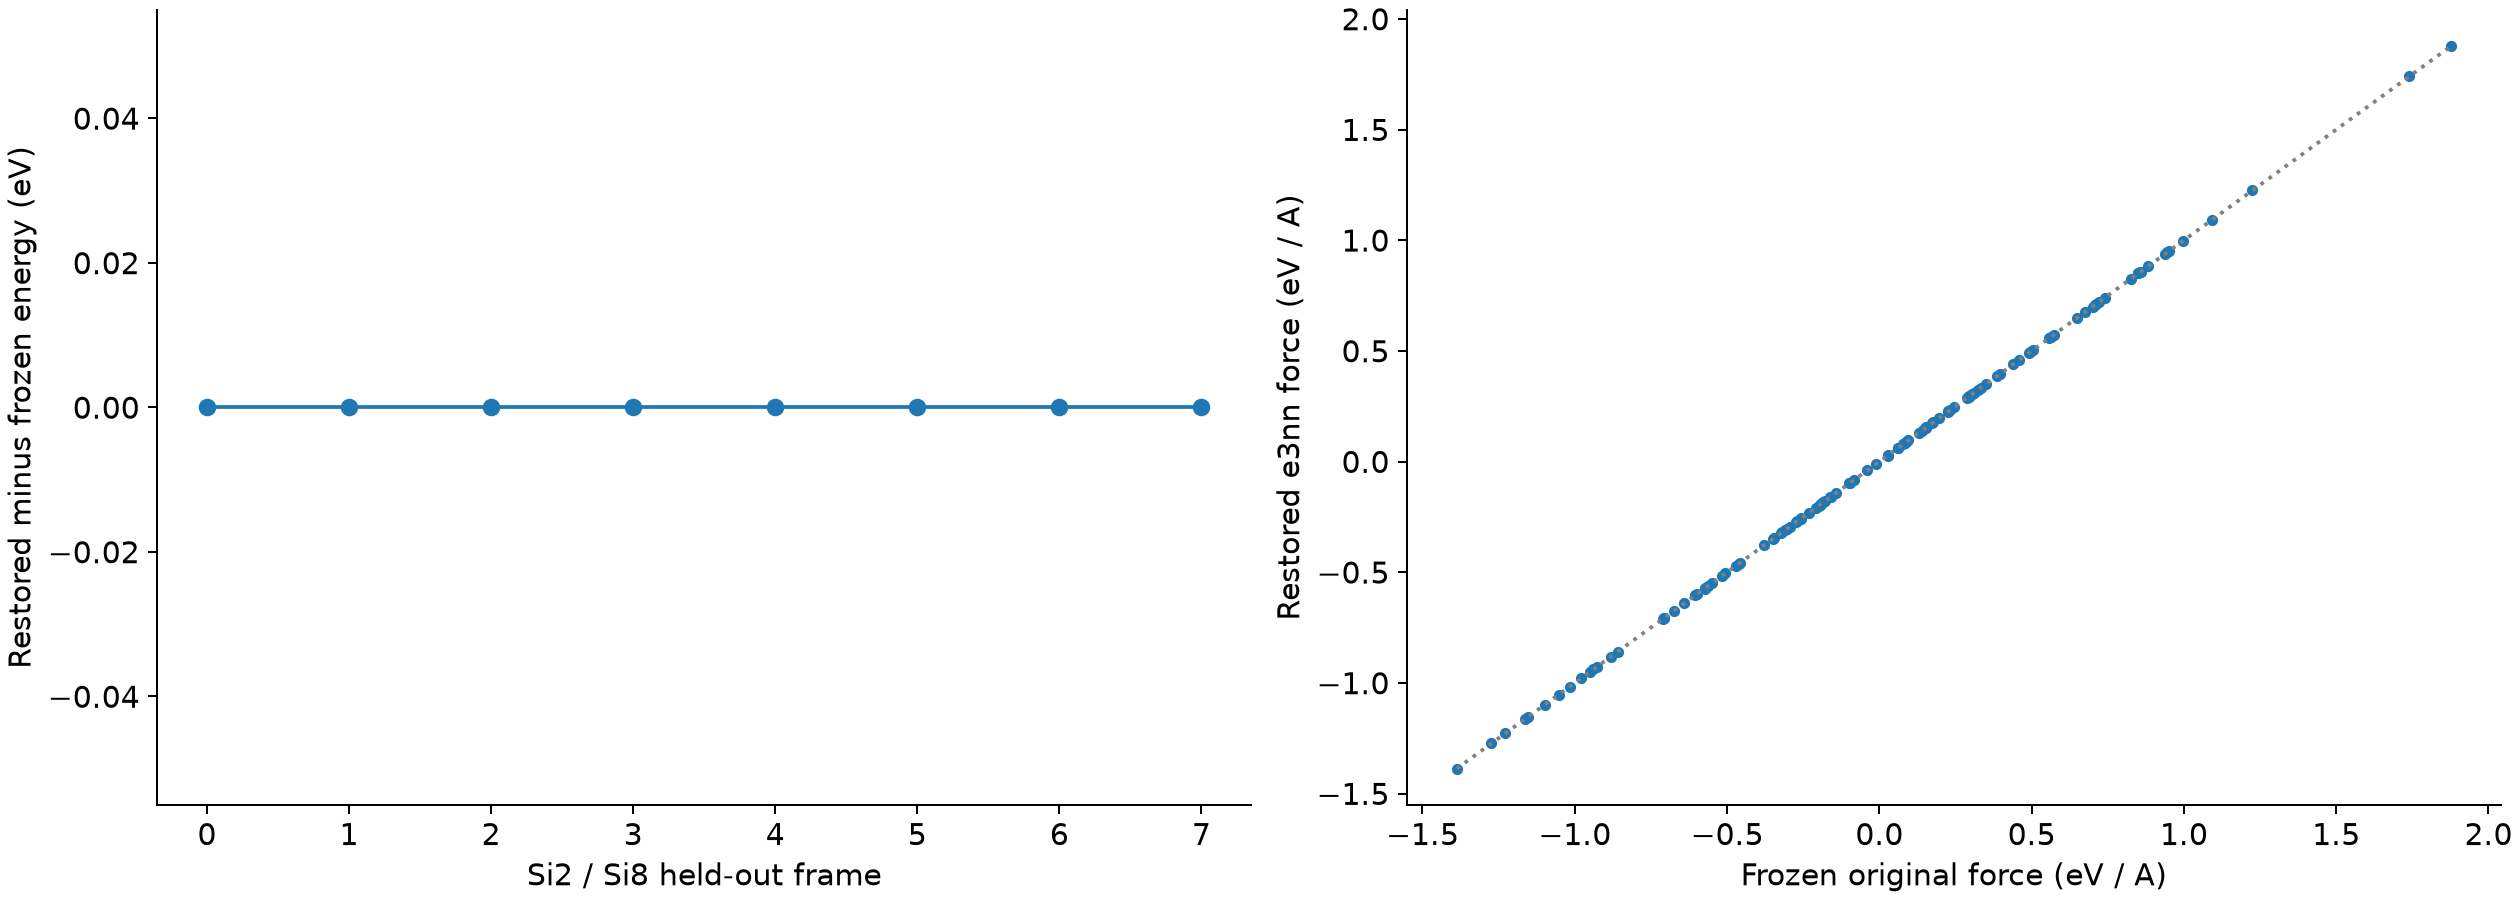
head -n 9 analysis-read/MACE-format-roundtrip-energy.csv
head -n 9 analysis-read/MACE-format-roundtrip-forces.csv
head -n 9 analysis-read/MACE-format-roundtrip-stress.csv
CSV同时保留恢复模型与原模型已有结果,便于按自己的结构或分量重新绘图。
5 为什么这里没有给P100和V100的cuEquivariance加速结果#
P100对应计算能力sm_60,V100对应sm_70。本例实际检查的cuEquivariance ops 0.7.0 CUDA12预编译库,CUBIN目标从sm_75开始,附带的PTX也没有可供这两种架构使用的较低目标。因此不能拿这份包在两种卡上直接宣称cuEquivariance加速。
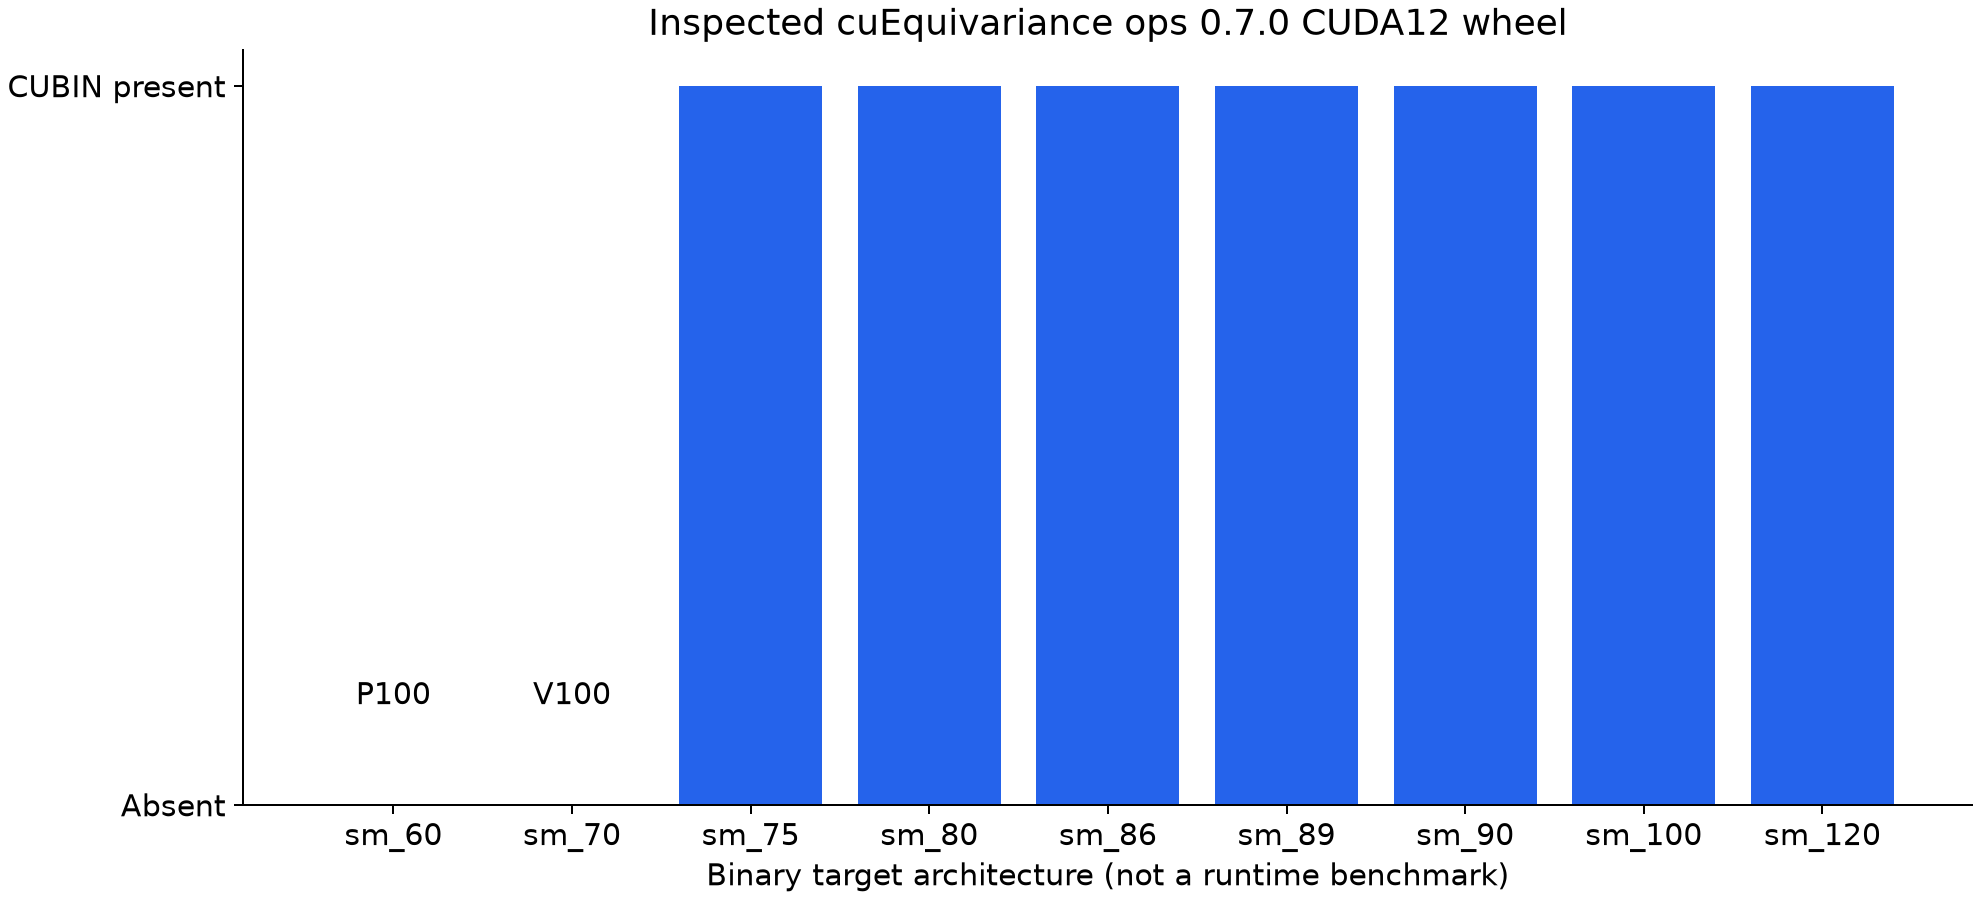
cat analysis-read/MACE-cueq07-wheel-architecture.csv
这项结论只针对所列版本和所检查的包,不代表所有历史版本、其他编译方式或未来版本都相同。格式转换仍可以在CPU完成,用于模型准备与格式检查;需要实际加速时,还要匹配CUDA、PyTorch、内核包和GPU架构,并在目标设备比较能量与力。
关于加速库与版本条件,参阅MACE官方cuEquivariance说明、NVIDIA cuEquivariance文档和NVIDIA历史GPU计算能力表。