
MACE多头回放微调实操
同时学习PBEsol目标与保留PBE回放头,说明真实回放标签、训练集能量参考、提交与分头测试。
阅读本篇目录
多头回放微调在学习新任务时,把旧任务数据也放入训练,以不同输出头区分两套标签。本例让Default头学习PBEsol,pt_head头回放PBE;两套标签均来自实际DFT计算。
这与普通“同时从头训练两个头”不同:这里从已训练的PBE模型初始化,再加入旧数据回放。它也与LoRA不同,本例不启用LoRA。
先准备数据与环境#
本组数据来自已经完成的Si₂、Si₈ PBE与PBEsol计算,共48个几何:32训练、8验证、8独立测试。同一几何在两个泛函下可以分别有标签,但训练、验证、测试的几何ID互不重叠。基模型是此前在PBE数据上训练得到的小模型,不是通用材料基础模型。
python3 -m zipfile -e mace-lora-replay-wave962-*.zip .
cd mace-lora-replay
bash read.sh
bash plot.sh
默认读取附带结果,不启动新训练。文件data/中的extxyz保存结构、REF_energy、REF_forces和应力等标签;不能把模型自身的预测重新标成DFT真值。一个完整的双原子训练帧如下:
2
Lattice="0.0 2.77297309 2.77297309 2.77297309 0.0 2.77297309 2.77297309 2.77297309 0.0" Properties=species:S:1:pos:R:3:REF_forces:R:3 REF_energy=-11.23714237 REF_stress="_JSON [[0.02735552809284883, 0.001948741536648442, 0.00818160826329791], [0.001948741536648442, 0.027485975352711876, -0.007389524067632682], [0.00818160826329791, -0.007389524067632682, 0.026808148691218253]]" REF_virials="_JSON [[-1.1665733850509004, -0.08310386124812395, -0.3489037540960845], [-0.08310386124812395, -1.1721362936152147, 0.3151254136361152], [-0.3489037540960845, 0.3151254136361152, -1.1432304527083057]]" geometry_id=Si2-00 split=train xc=PBEsol config_type=Si2 pbc="T T T"
Si       0.01560990       2.74746179       2.74898155      -0.54675093       0.60544867       0.13674030
Si       1.35844832       1.40949393       1.36837537       0.54675093      -0.60544867      -0.13674030
MACE版本0.3.16,Python3.11、PyTorch2.8.0/CUDA12.6、e3nn0.4.4;训练使用一张V10016G。小例采用float64。更换模型规模、材料或训练分布后,应重新检查误差。
在自己的解压目录准备新训练#
module load mace/0.3.16
python setup.py
python prepare.py
setup.py针对本篇单元素Si模型生成一个个人目录内的训练程序副本,保留单元素原子能量数组的维度;它不改变公共MACE安装。脚本会核对匹配的0.3.16源码,版本不同应采用对应方法。
已经有private或work-new时,请保留原结果并使用新的解压目录。下面两种方法使用同一个基模型与同一组数据,修改自己的任务时,先调整configs/内的YAML,再准备目录。
看完整回放配置#
cat configs/replay.yml
name: replay
energy_key: REF_energy
forces_key: REF_forces
stress_key: REF_stress
virials_key: REF_virials
E0s: estimated
model: MACE
batch_size: 4
valid_batch_size: 4
max_num_epochs: 40
default_dtype: float64
seed: 29
loss: stress
energy_weight: 1.0
forces_weight: 100.0
stress_weight: 1.0
compute_stress: true
ema: false
ema_decay: 0.999
swa: false
num_workers: 0
device: cuda
log_dir: logs
model_dir: models
checkpoints_dir: checkpoints
results_dir: results
lr: 0.001
weight_decay: 0.0
config_type_weights: '{''Si2'':1.0,''Si8'':1.0}'
foundation_model: ../../models/base-PBE.model
multiheads_finetuning: true
train_file: ../../data/PBEsol-train.xyz
valid_file: ../../data/PBEsol-valid.xyz
foundation_head: Default
pt_train_file: ../../data/PBE-train.xyz
pt_valid_file: ../../data/PBE-valid.xyz
num_samples_pt: 32
force_mh_ft_lr: true
weight_pt_head: 1.0
train_file、valid_file属于PBEsol目标。pt_train_file、pt_valid_file属于PBE回放,multiheads_finetuning: true开启这一路径。
pseudolabel_replay未开启:本例使用旧DFT标签,不把基模型预测冒充旧DFT数据。weight_pt_head控制回放损失的权重;具体比例应根据新旧任务需求检查,不认为1.0对所有体系最优。
force_mh_ft_lr: true明确使用配置中的学习率0.001,避免自动多头学习率规则与自己的设置混淆。这里关闭EMA和SWA,便于理解最小例子。
新旧任务的能量参考要处理一致#
本例目标头使用E0s: estimated。它利用目标训练集与基模型预测来估计目标原子能量参考,不使用验证集或测试集标签做平移拟合;回放头仍沿用旧模型的参考。
PBE与PBEsol的绝对能量参考不同,直接将旧参考套到新头,可能造成近似常量的能量偏差。应在训练输入中处理这一点,不在拿到测试结果后人为平移能量来宣称误差更低。
提交训练并分别读取两个头#
cd work-new/replay
sbatch submit.sh
完成后,保存模型为models/replay.model。在资料包根目录,可以分别提交两个读取任务:
cd ../..
bash evaluate.sh replay
bash evaluate.sh replay pt_head
第一个使用PBEsol测试数据读取目标头,第二个使用PBE测试数据读取回放头;输出分别为:
work-new/evaluate-replay-Default.xyz
work-new/evaluate-replay-pt_head.xyz
核心工具是mace_eval_configs,--head应明确对应标签。不能把PBE测试标签与PBEsol头混在一起计算误差。
实际得到什么#
| 40轮回放模型的输出头 | 对应标签 | 能量RMSE(eV/原子) | 力RMSE(eV/Å) |
|---|---|---|---|
| Default | PBEsol | 0.051677 | 0.019622 |
| pt_head | PBE | 0.050990 | 0.016107 |
两个头各有8个独立测试几何。回放头的表现要与旧任务需求一起检查;这里没有声称旧任务所有性质完全不变,也没有证明回放一定优于所有不回放设置。
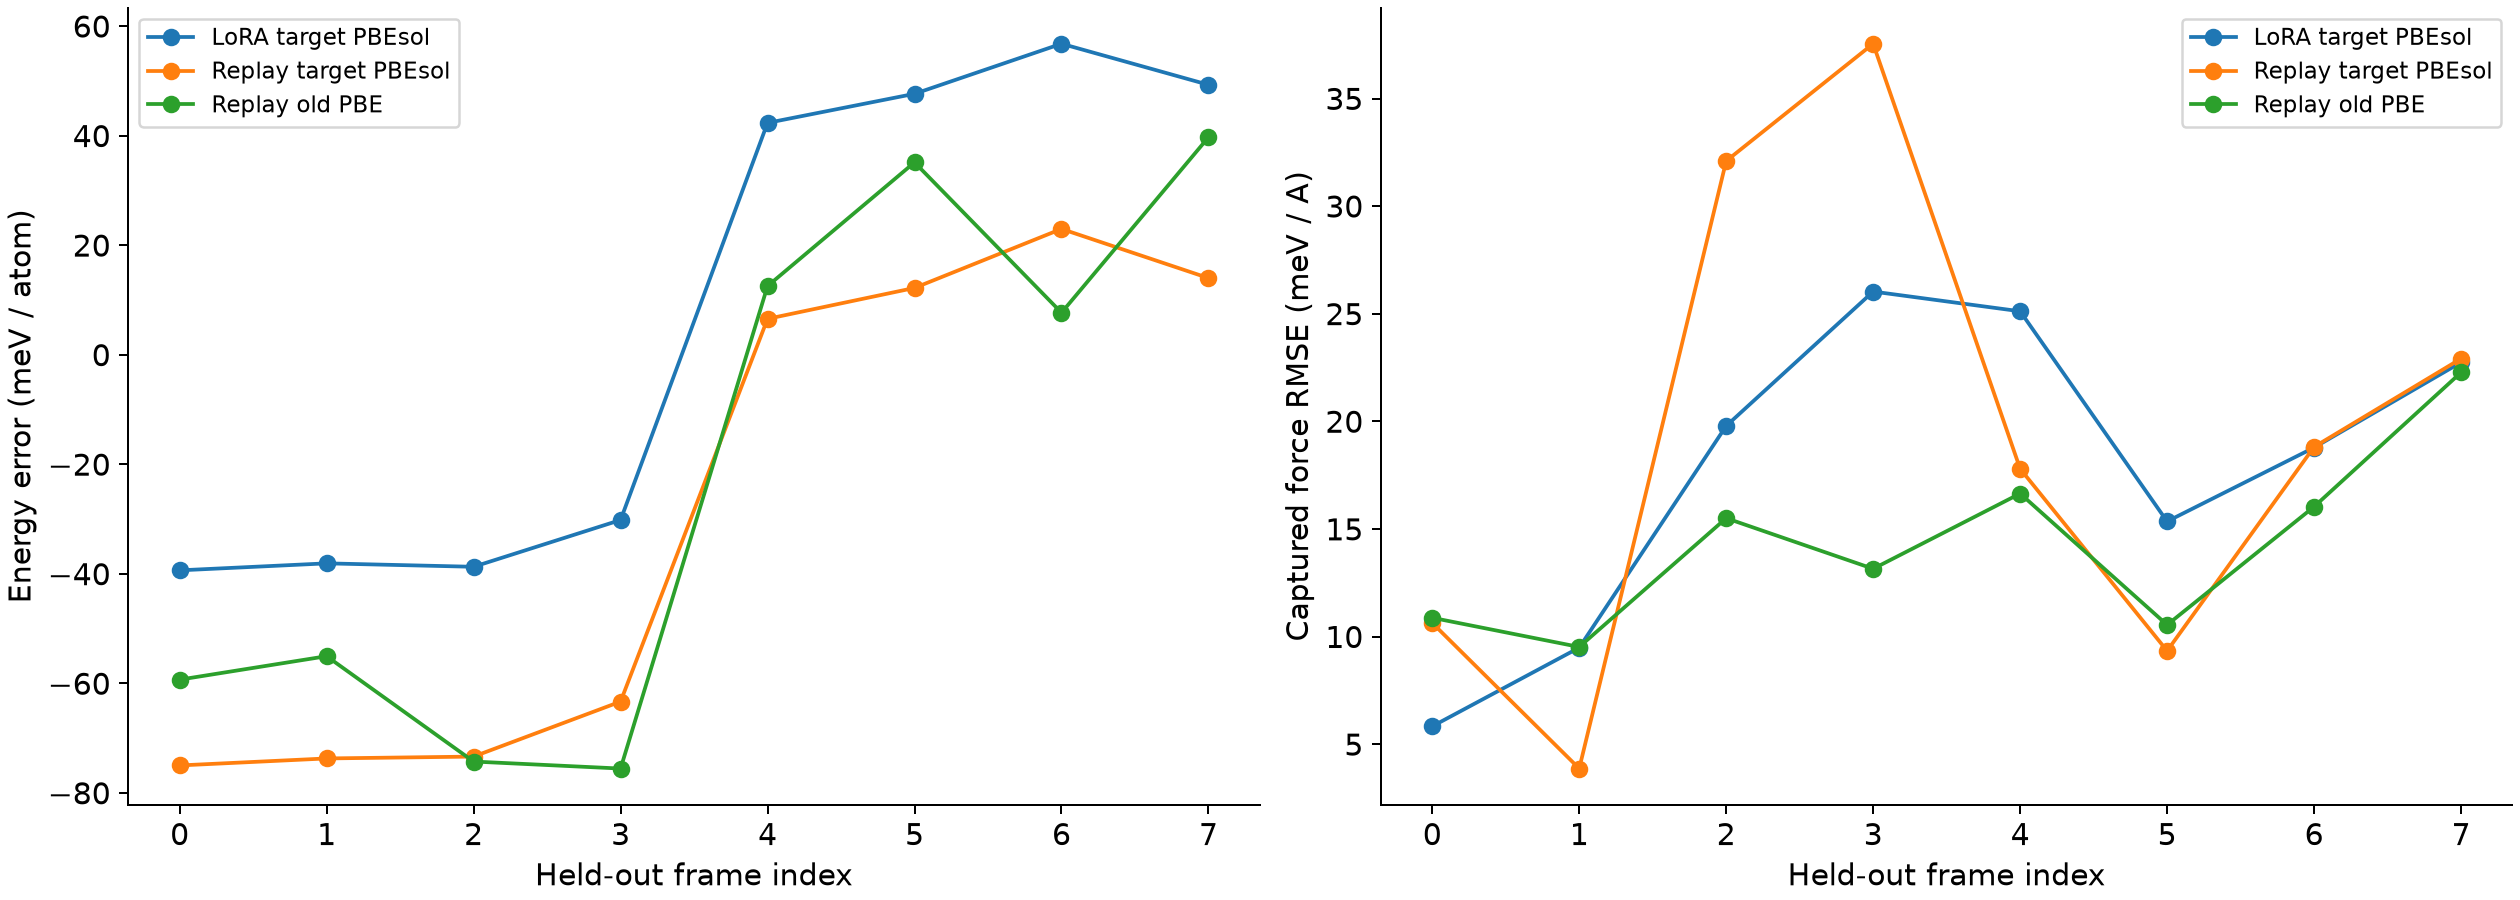
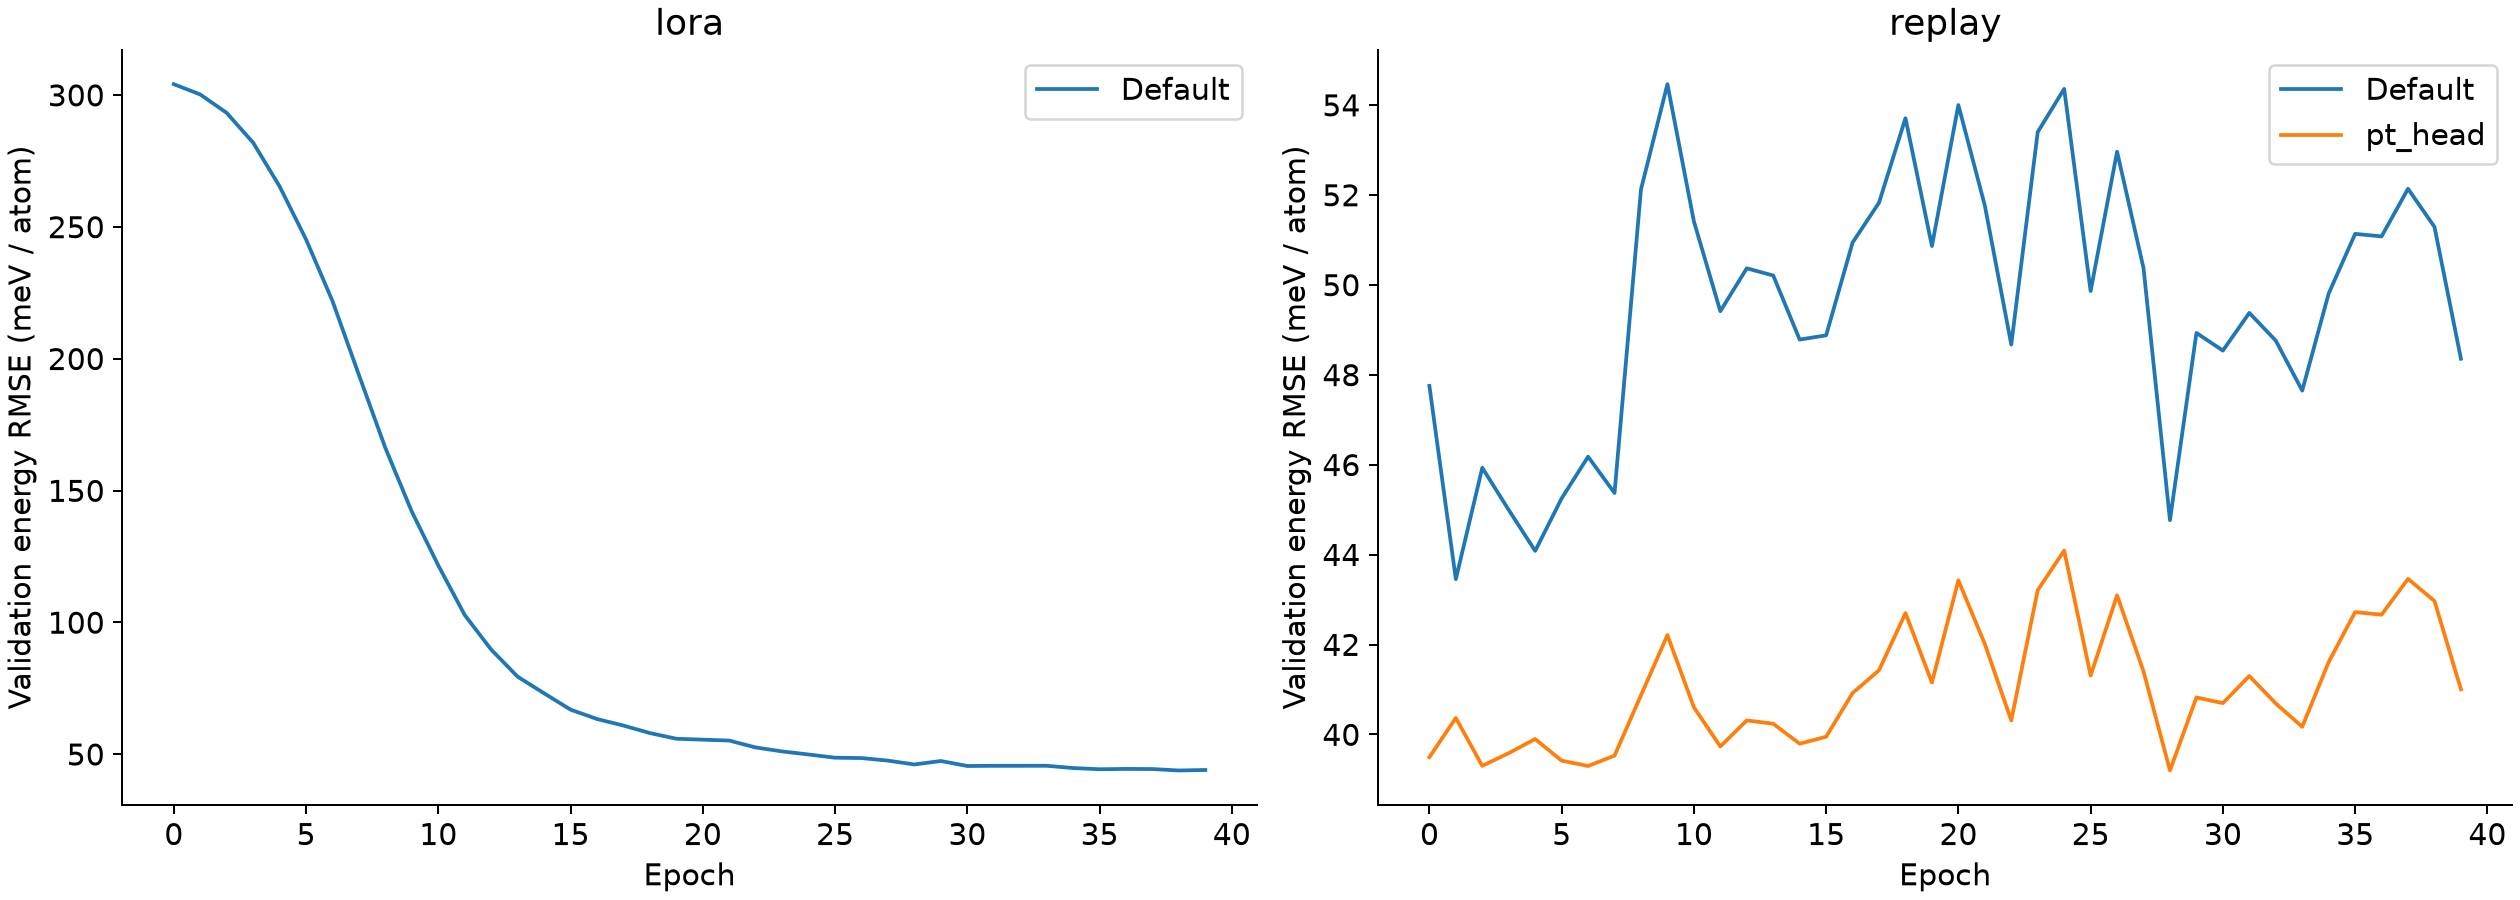
默认的bash read.sh与bash plot.sh仅整理附带数据,输出逐帧能量、力RMSE摘要和整体指标。它们与对自己新训练模型执行bash evaluate.sh是两步不同的操作。
本例只覆盖Si₂/Si₈近平衡构型,不用于判断复杂多元素通用势的遗忘程度。实际项目需为新旧任务分别准备足够的独立数据,检查能量、力、应力以及目标物性。
相关概念见MACE官方微调文档。LoRA的单头方法另见LoRA微调实操。