
LAMMPS面外距离势的CPU、OpenMP与GPU入口
distance、distharm、sqdistharm的基础CPU、两线程OpenMP和P100/V100 16GB KOKKOS实际命令与数值对照。
阅读本篇目录
下载四平台完整输入、输出和绘图程序(ZIP)。结构、参数单位及平衡距离平方的解释见面外距离势实例。这里使用相同数据文件和势参数,对照基础CPU与加速实现。
1 先读取参考数据#
unzip lammps-outofplane-distance-wave1034-*.zip
cd lammps-outofplane-distance
bash read.sh
bash plot.sh
cat analysis/LAMMPS-distance-suffix-comparison.csv
包含3个基础CPU配置、3个OpenMP配置,以及三种KOKKOS样式分别在P100/V100 16GB的6个配置,共12个配置、108个固定构型。读取脚本逐项比较坐标、能量与全部12个原子力分量。
2 基础CPU:一个任务一个核心#
cat base.slurm
sbatch base.slurm
使用lammps/30Sep2026-8173m,Intel oneAPI 2024.2 / Intel MPI构建。输入选择基础distance、distharm、sqdistharm,分别在独立目录执行lmp -in in.lammps。脚本设置OMP_NUM_THREADS=1。
3 OpenMP:后缀与线程申请对应#
improper_style distharm/omp
improper_coeff 1 2.0 0.5
在申请到2个CPU核心的资源里运行:
module load lammps/30Sep2026-8173m
export OMP_NUM_THREADS=2
lmp -pk omp 2 -in in.lammps
完整三组可直接提交:
cat omp.slurm
sbatch omp.slurm
该脚本申请1个任务、每任务2个CPU核心,依次运行distance/omp、distharm/omp、sqdistharm/omp。增加线程数时要同步调整Slurm的cpus-per-task。
4 KOKKOS:分别使用对应GPU构建#
GPU构建使用GCC 13.3、Open MPI、CUDA 12.8及Kokkos 5.2.1双精度。P100的输入示例:
improper_style distharm/kk
improper_coeff 1 2.0 0.5
module load lammps/30Sep2026-p100-kokkos
export OMP_NUM_THREADS=1
mpirun --bind-to none -np 1 lmp -k on g 1 -sf kk   -pk kokkos neigh half newton on -in in.lammps
完整作业使用短命令:
sbatch p100.slurm
sbatch v10016.slurm
P100脚本使用gpu-8p100-hs与gpu:p100-16g:1;V100 16GB使用gpu-8v100-16g-hs与gpu:v100-16g:1,模块改为lammps/30Sep2026-v100-kokkos。每份GPU脚本只申请1张卡,依次运行三种/kk样式。账号可用分区不同的,按门户或相应模板选择;模块、GPU型号与GRES保持匹配。
四个平台都沿用已核对的拓扑4 1 2 3及相同的d₀/d₀²,没有为某个平台更换原子顺序或参数。
5 实际对照与读取#
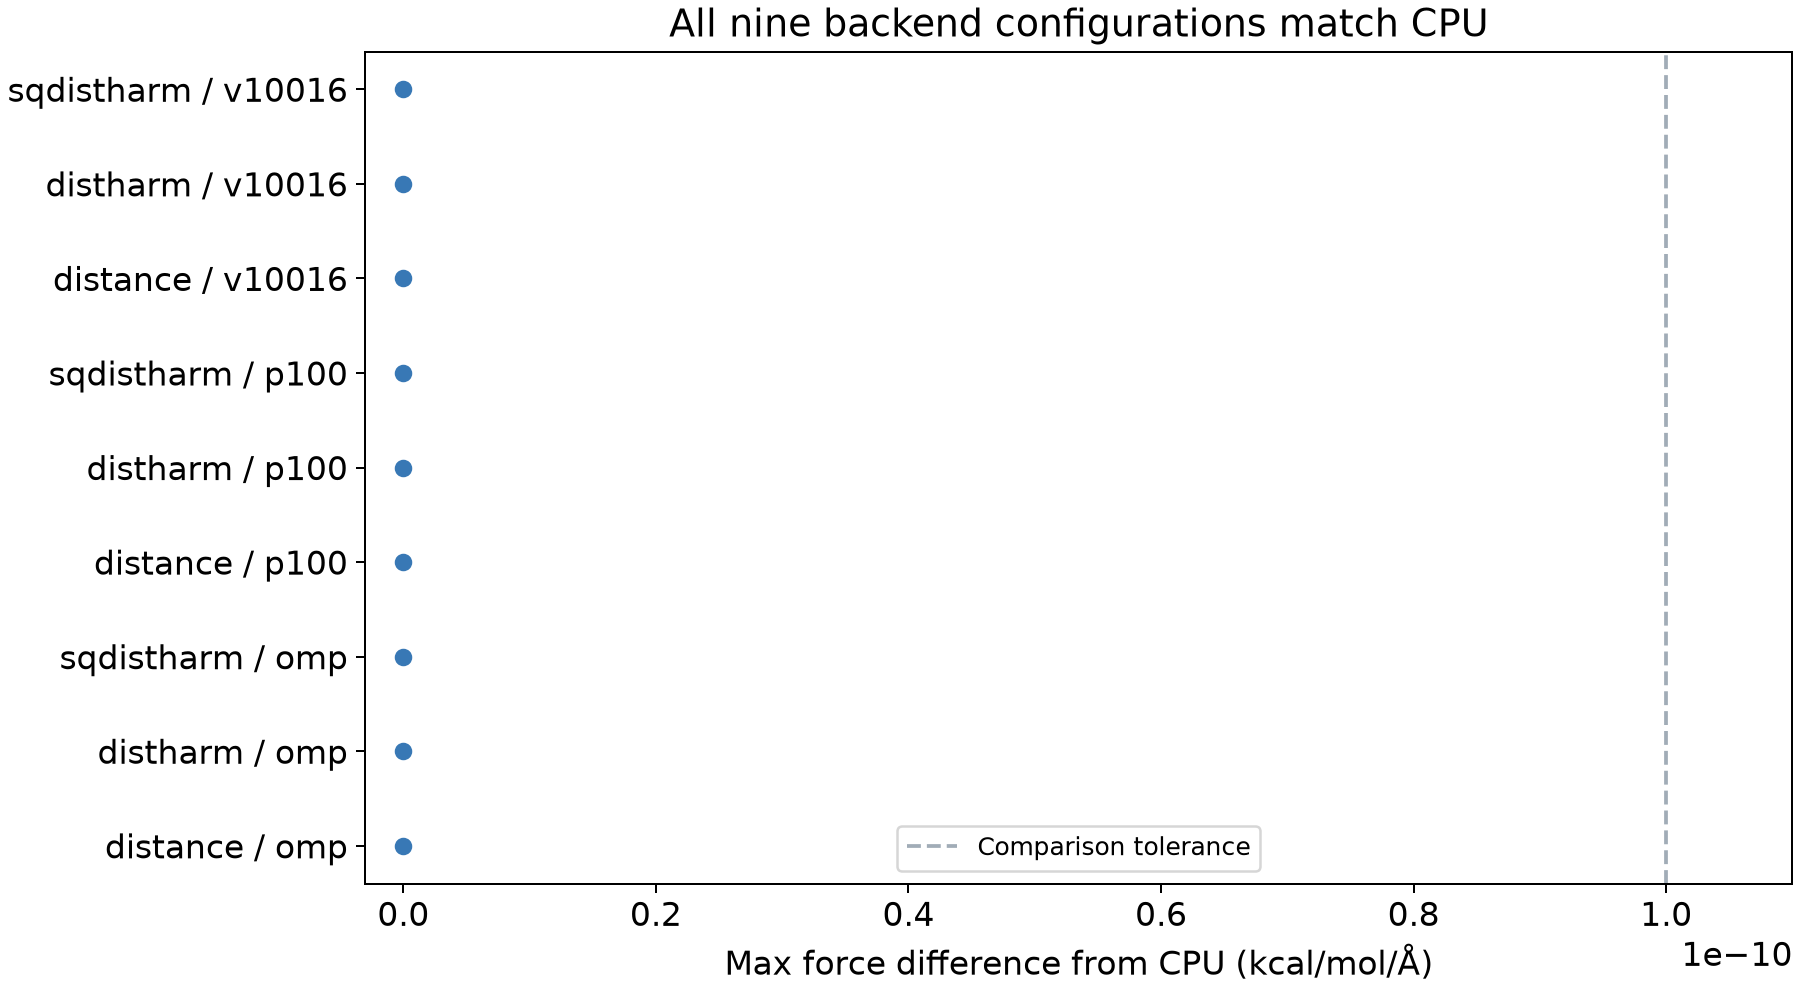
在这组输出的打印精度下,9个加速配置的能量和全部原子力与相应CPU基准逐项一致。图中的零值是实际差值;虚线标示本例比较尺度,不表示速度或统计误差。
这些都是四原子、run 0固定构型计算,总耗时主要受初始化影响。需要评价生产任务的加速比时,应另用目标规模、实际非键/多体势及足够步数测试。
所有平台作业完成后:
bash read.sh work-new analysis-new
bash plot.sh analysis-new
work-new/base/、omp/、p100/和v10016/分别保存自己的新输出;目录存在时脚本不会覆盖。参考数据在reference-results/中,运行前复制并解压到自己的工作目录。
本例实跑范围是上述三种势及其OpenMP/KOKKOS入口,使用P100和V100 16GB;实际输入与数据在附件中逐组列出。