
PLUMED蛋白质构象与二级结构分析
从1CRN真实结构出发,补氢并运行ALPHARMSD、ANTIBETARMSD和PARABETARMSD,查看逐片段RMSD与连续结构得分。
阅读本篇目录
下载完整输入、实际输出、原始PDB、分析脚本和图片(ZIP)。本例用46残基的Crambin蛋白演示三种二级结构指标:α螺旋、反平行β折叠和平行β折叠。先准备结构,再分析片段,最后把结果画出来;不需要GPU。
1 先查看已经算好的结果#
解压进入plumed-protein-secondary:
bash read.sh
bash plot.sh
head -10 analysis/PLUMED-protein-secondary-scores.csv
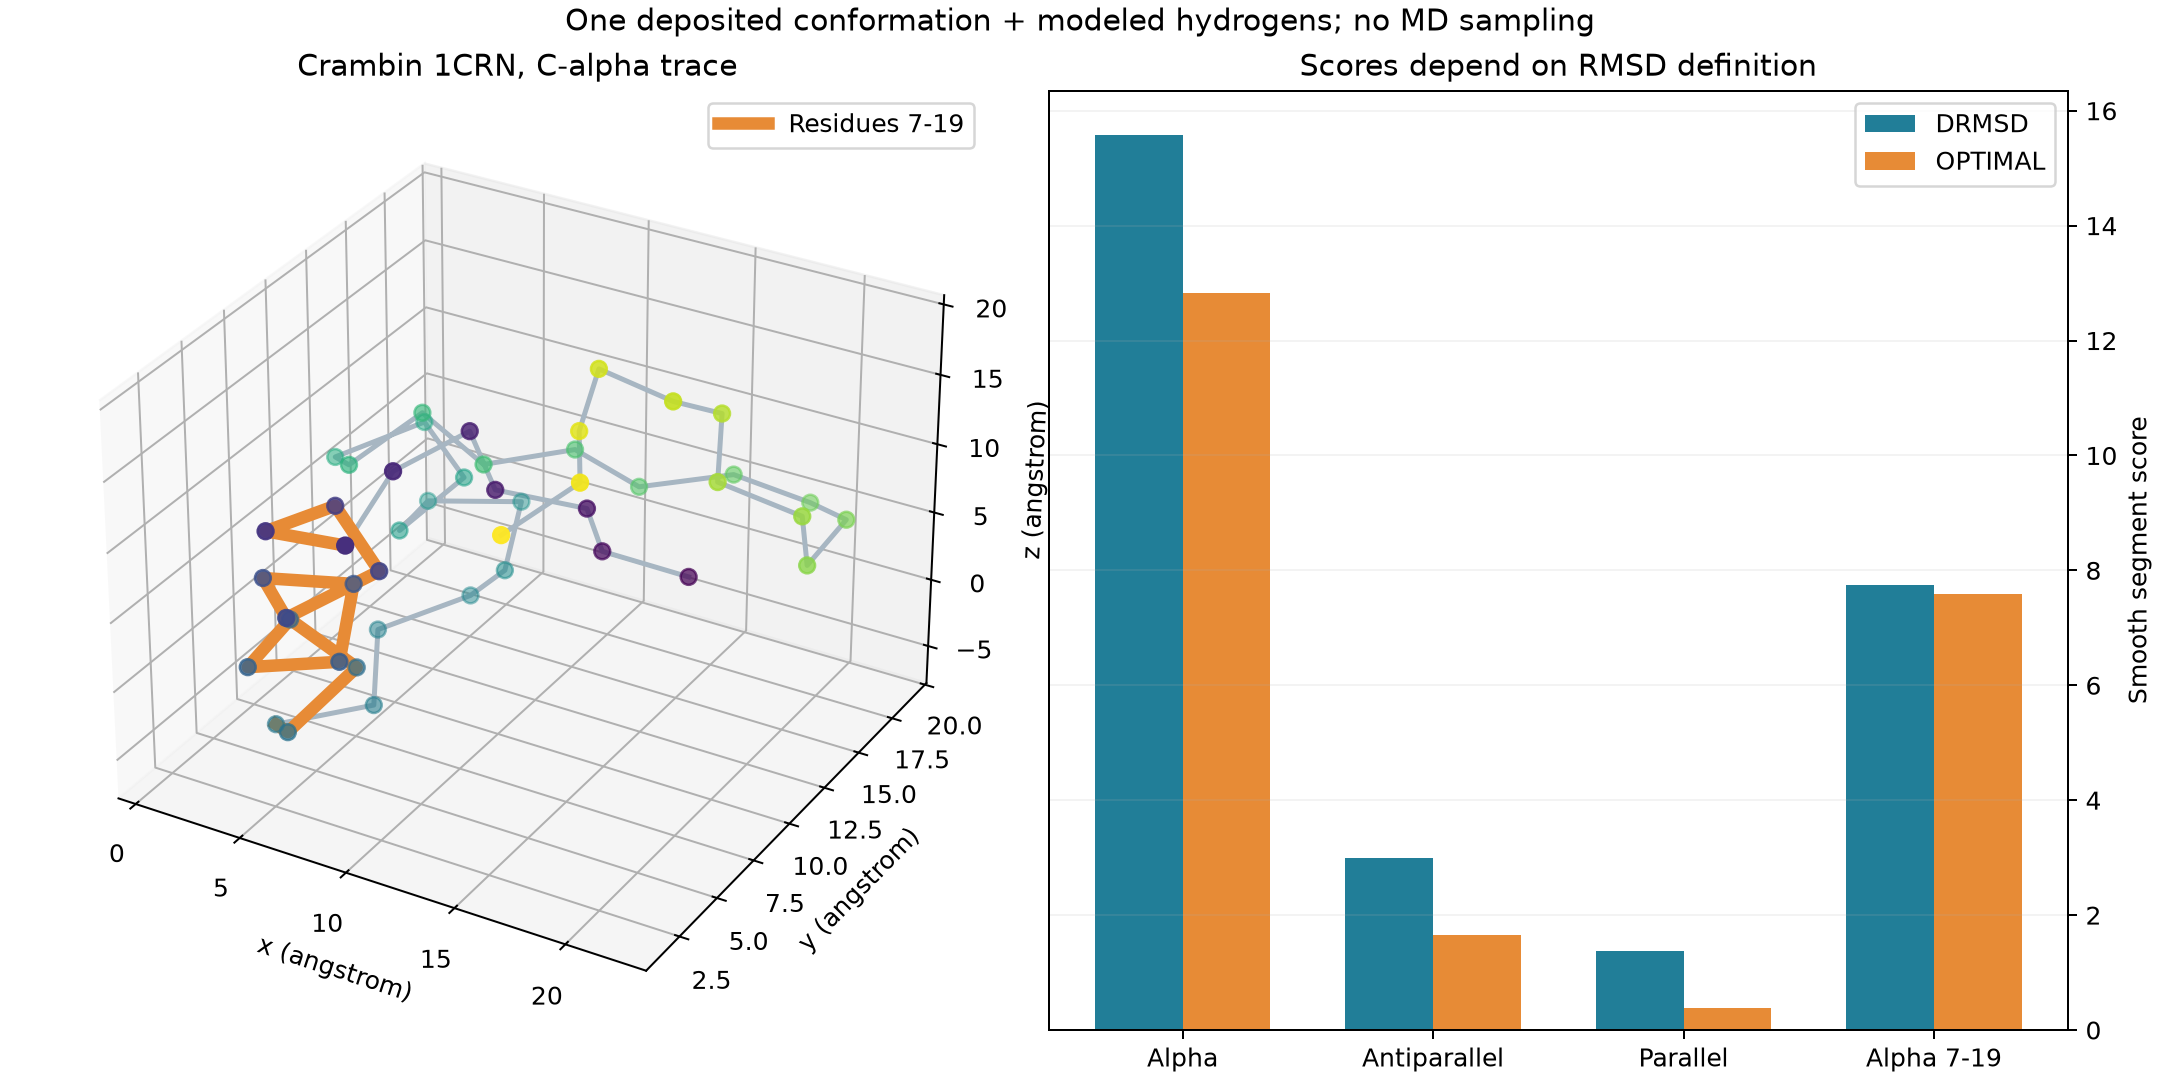
源结构来自RCSB的1CRN条目,含327个重原子。GROMACS补氢后为642个原子;氢坐标是工具生成的,不是晶体条目中的实验氢坐标。本例未做能量最小化或MD采样。
XYZ有三帧:补氢结构、整体平移、整体旋转再平移。这三帧是同一个构象,用来演示指标不应随整体位置和方向改变,不代表蛋白质随时间发生结构变化。PLUMED输出的0、1、2这里只是帧索引。
2 从PDB开始准备#
包内已有准备好的输入;下面展示本例实际采用的补氢步骤。若要重复准备,使用新的示例目录:
mkdir preparation
cd preparation
curl -L https://files.rcsb.org/download/1CRN.pdb -o 1CRN.pdb
# 只取ATOM记录,本条目是单链蛋白
awk '/^ATOM/{print} END{print "TER"; print "END"}' 1CRN.pdb > heavy.pdb
/public/software/gromacs/2026.4/cpu-double/bin/gmx_d pdb2gmx   -f heavy.pdb -o hydrogenated.pdb -p topol.top   -ff amber99sb-ildn -water tip3p -ignh
cd ..
/public/toolkit/miniconda3/envs/ase-3.29.0/bin/python prepare-inputs.py
本例GROMACS实际报告2026.4-dev (double precision)。所选力场为Amber99SB-ILDN;-water tip3p指定拓扑中的水模型,命令没有向本例添加水盒。GROMACS识别了蛋白的二硫键,pdb2gmx本身不运行分子动力学。
prepare-inputs.py生成inputs-prepared,并与包内完整输入逐字节比较。它保留坐标和原子序号,只把末端OC1/OC2名称写成分析工具认识的O/OXT。末端两个羧酸氧按GROMACS顺序命名,可能与原始PDB的O/OXT标签互换;重原子坐标集合没有变化。轨迹单位从PDB的Å换成nm。
为什么要补氢?这些指标每个残基取N、CA、CB、C、O五个位置;甘氨酸没有CB,当前工具需要相应的HA2位置。原始重原子PDB不能直接用于这一套选择。换成自己的蛋白时,也要先检查缺失原子、残基名称、氢命名和末端命名,不能简单按原子总数猜测。
3 完整PLUMED输入#
inputs/DRMSD/plumed.dat:
UNITS LENGTH=nm ENERGY=kj/mol TIME=ps
MOLINFO STRUCTURE=structure.pdb MOLTYPE=protein
alpha: ALPHARMSD RESIDUES=all TYPE=DRMSD R_0=0.08 NN=8 MM=12 NOPBC
DUMPVECTOR ARG=alpha_rmsd FILE=alpha-rmsd.dat STRIDE=1 FMT=%24.16e
anti: ANTIBETARMSD RESIDUES=all TYPE=DRMSD R_0=0.08 NN=8 MM=12 NOPBC STRANDS_CUTOFF=1
DUMPVECTOR ARG=anti_rmsd FILE=anti-rmsd.dat STRIDE=1 FMT=%24.16e
para: PARABETARMSD RESIDUES=all TYPE=DRMSD R_0=0.08 NN=8 MM=12 NOPBC STRANDS_CUTOFF=1
DUMPVECTOR ARG=para_low FILE=para-rmsd.dat STRIDE=1 FMT=%24.16e
helix: ALPHARMSD RESIDUES=7-19 TYPE=DRMSD R_0=0.08 NN=8 MM=12 NOPBC
DUMPVECTOR ARG=helix_rmsd FILE=helix-rmsd.dat STRIDE=1 FMT=%24.16e
PRINT ARG=alpha,anti,para,helix FILE=COLVAR STRIDE=1 FMT=%24.16e
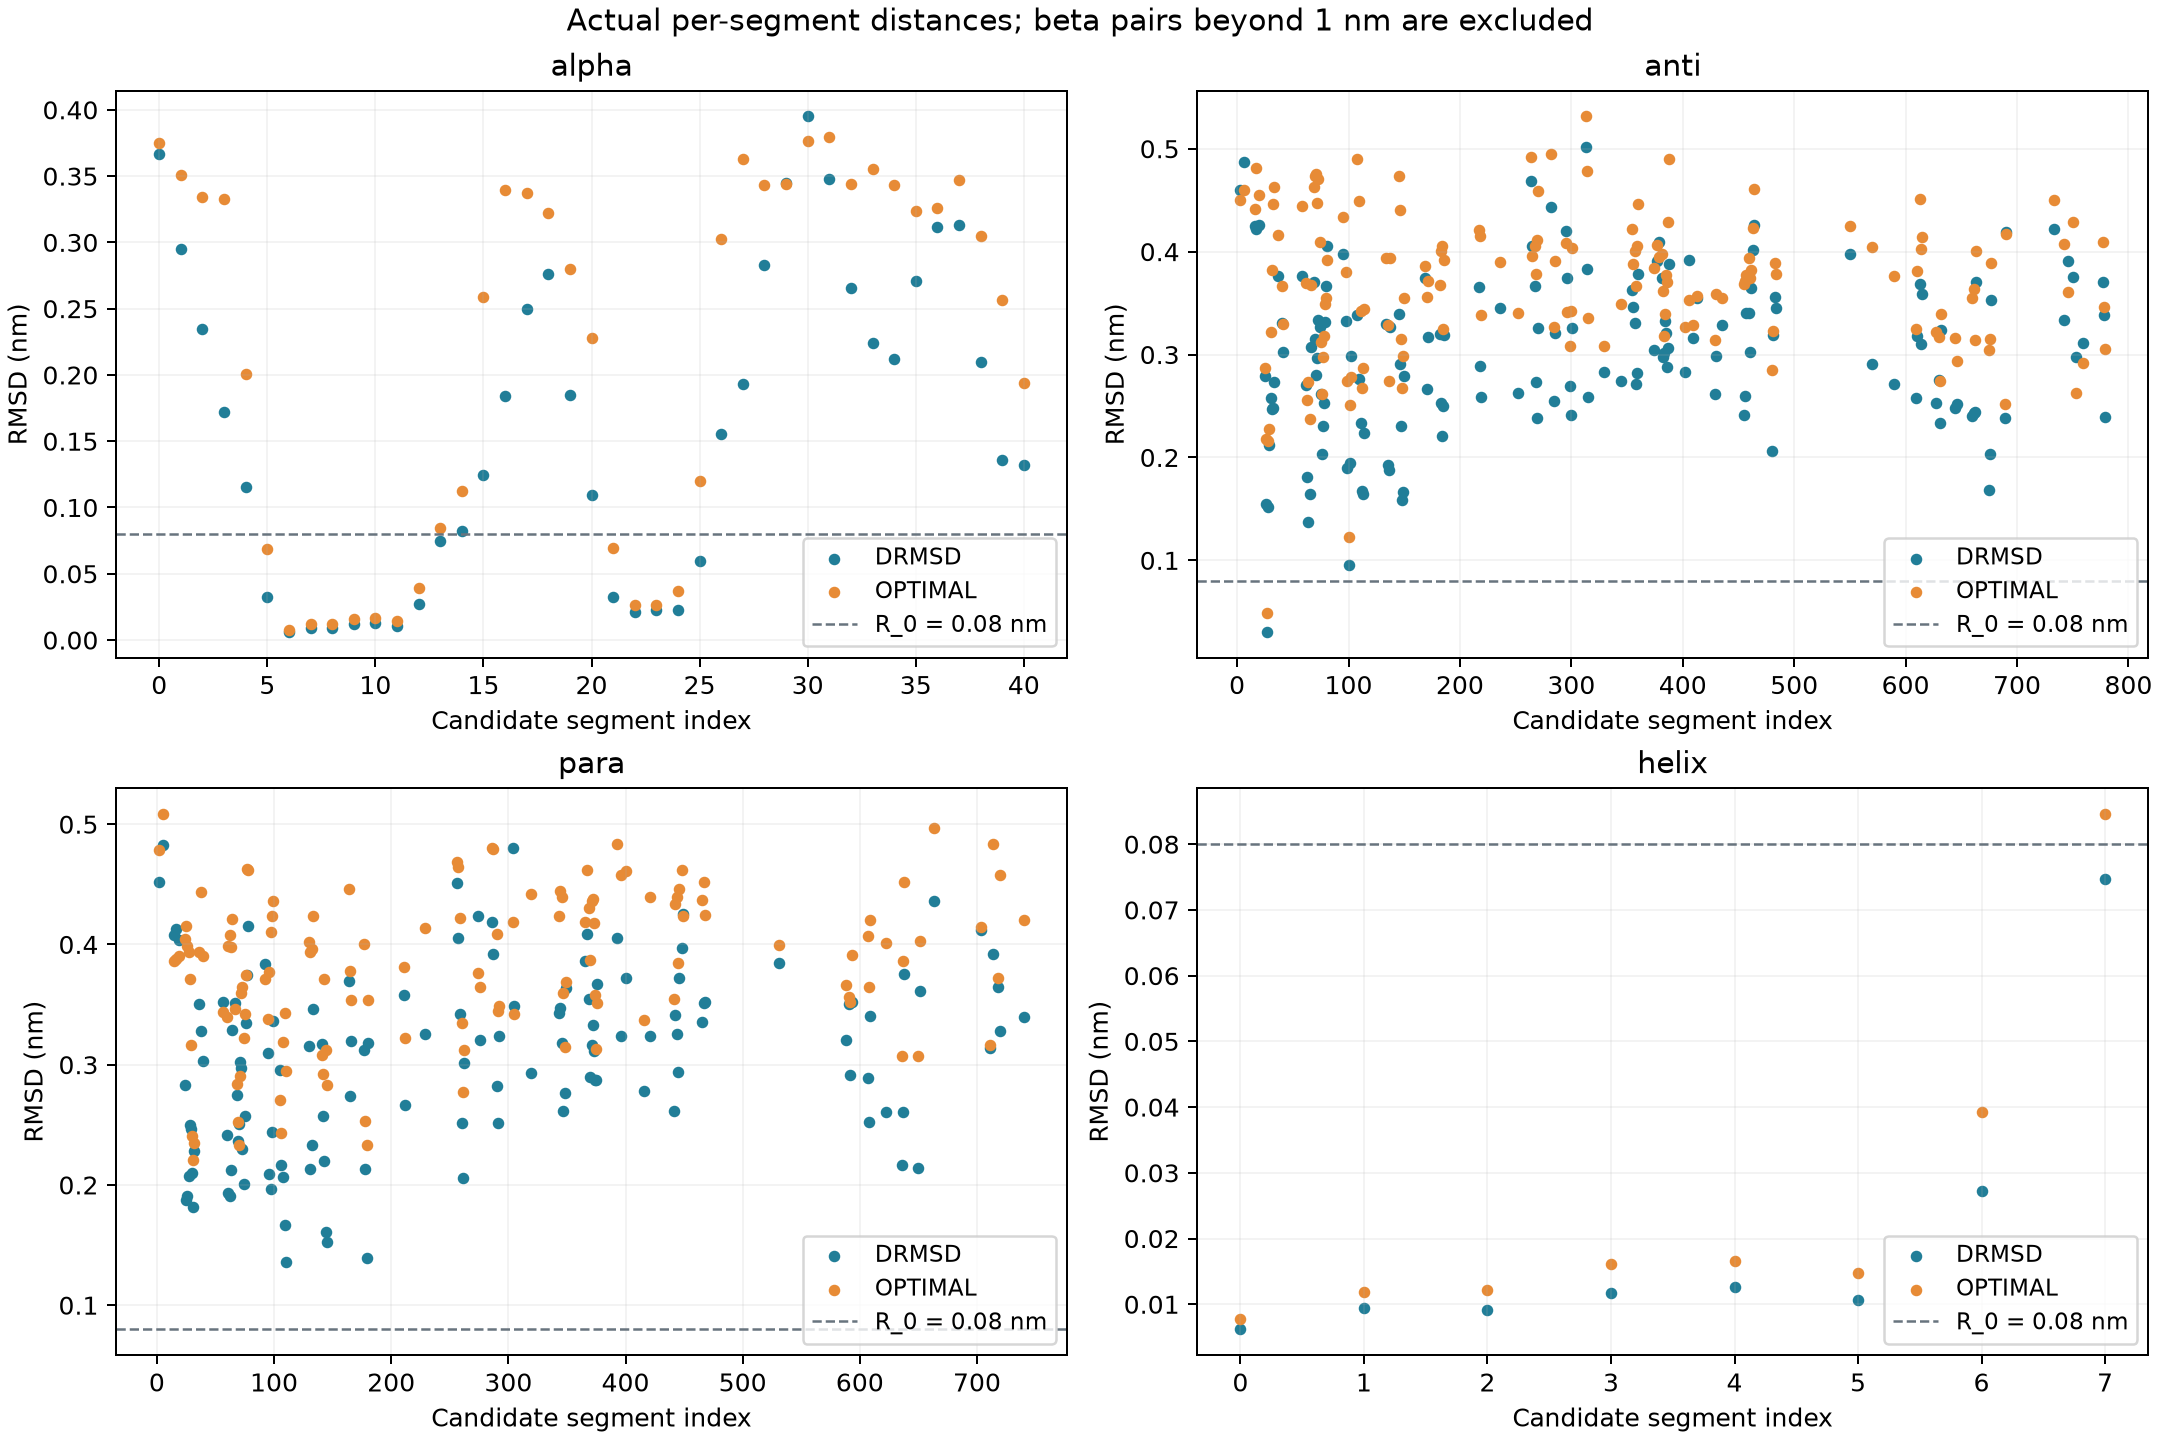
RESIDUES=all扫描整条链;helix只分析7到19号残基。α螺旋用连续6个残基作为候选片段,所以整条46残基链有41个候选,7到19号共有8个。β折叠比较两段各3个残基,本例反平行有780对、平行有741对候选,超过STRANDS_CUTOFF=1 nm的片段对不参与得分。
R_0=0.08的单位为nm;NN=8 MM=12控制平滑切换函数。每个候选片段先求它与理想二级结构的距离,再累加连续权重。结果可以是小数,不是螺旋百分比,也不是DSSP残基占比。重叠片段会重复涉及同一残基,不要用得分直接除以46当作二级结构含量。
本安装中alpha、anti、para是最终标量;alpha_rmsd、anti_rmsd和para_low是逐片段距离向量。平行β折叠会比较两个理想参考并取较小距离。上面的输出标签已在当前安装中实际运行,不必照搬其他版本的分量名称。
4 自己提交重新分析#
sbatch run.slurm
# 作业结束后
bash read.sh work-new analysis-new
bash plot.sh analysis-new
模板按CPU队列规则预留56核,例子实际使用单线程,两组各约0.8秒;它会新建work-new保存结果,不覆盖参考输出。已有同名目录时请保留它,另建工作目录。
工具是集群PLUMED2.10.1,编译环境为Intel oneAPI C++2024.2.1、IntelMPI2021.13;无需编译本地插件。实际核心命令为:
source environment.sh
cd inputs/DRMSD
plumed driver --plumed plumed.dat --ixyz trajectory.xyz --length-units nm
若直接执行核心命令,也应先复制输入目录到自己的新工作目录,保留参考文件。run.sh会自动完成这一步。
5 DRMSD和OPTIMAL怎样选择#
DRMSD比较原子间距离,OPTIMAL先做最佳刚体叠合,再求坐标RMSD。包内两组只改变TYPE,没有把两种定义当成同一个量。
| 方法 | 整链α得分 | 反平行β得分 | 平行β得分 | 7–19号α得分 |
|---|---|---|---|---|
| DRMSD | 15.56985 | 3.00057 | 1.37546 | 7.75152 |
| OPTIMAL | 12.83211 | 1.64680 | 0.37488 | 7.58662 |
这是本例当前结构和阈值的结果,不能把两种方法的得分差当作结构真的发生了变化。逐片段距离更适合帮助你定位是哪一段贡献了螺旋或折叠信号。
6 输出怎么读、怎样换自己的数据#
head -8 reference-results/DRMSD/COLVAR
head -8 reference-results/DRMSD/analysis.0.alpha-rmsd.dat
head -8 analysis/PLUMED-protein-secondary-segments.csv
COLVAR每帧一行;当前DUMPVECTOR把前两帧存为analysis.0.*、analysis.1.*,不带前缀的向量文件保留最后一帧。β片段的未参与位置可能输出0,这种0不是“与理想折叠完全相同”;必须结合链间距离筛选判断。配套CSV有active列明确区分。
换轨迹时保持PDB序号与轨迹原子顺序一致,并选择正确的长度单位。本例分子完整且位于足够大的盒中,使用NOPBC;生产MD轨迹若分子跨边界,应根据盒信息先重建完整分子,尤其不要把断裂轨迹直接交给OPTIMAL。包内读取/画图脚本针对1CRN三帧数据,处理其他蛋白需调整残基数、片段枚举和轨迹读取。
定义与参数参见ALPHARMSD、ANTIBETARMSD和PARABETARMSD官方说明。这里展示结构描述量的操作,不据三帧刚体变换数据推断折叠平衡或动力学。
7 主链二面角与参考构象比较#
二级结构得分之外,常需要知道具体残基的φ、ψ角,以及它们与指定参考有多接近。下载主链角度完整输入、实际输出、CSV和图片(ZIP)。这是同一个1CRN结构的补充操作,仍然只有三个刚体相关帧,没有重新运行MD。
解压进入plumed-protein-dihedrals:
bash read.sh
bash plot.sh
head -8 analysis/PLUMED-protein-dihedral-similarity.csv
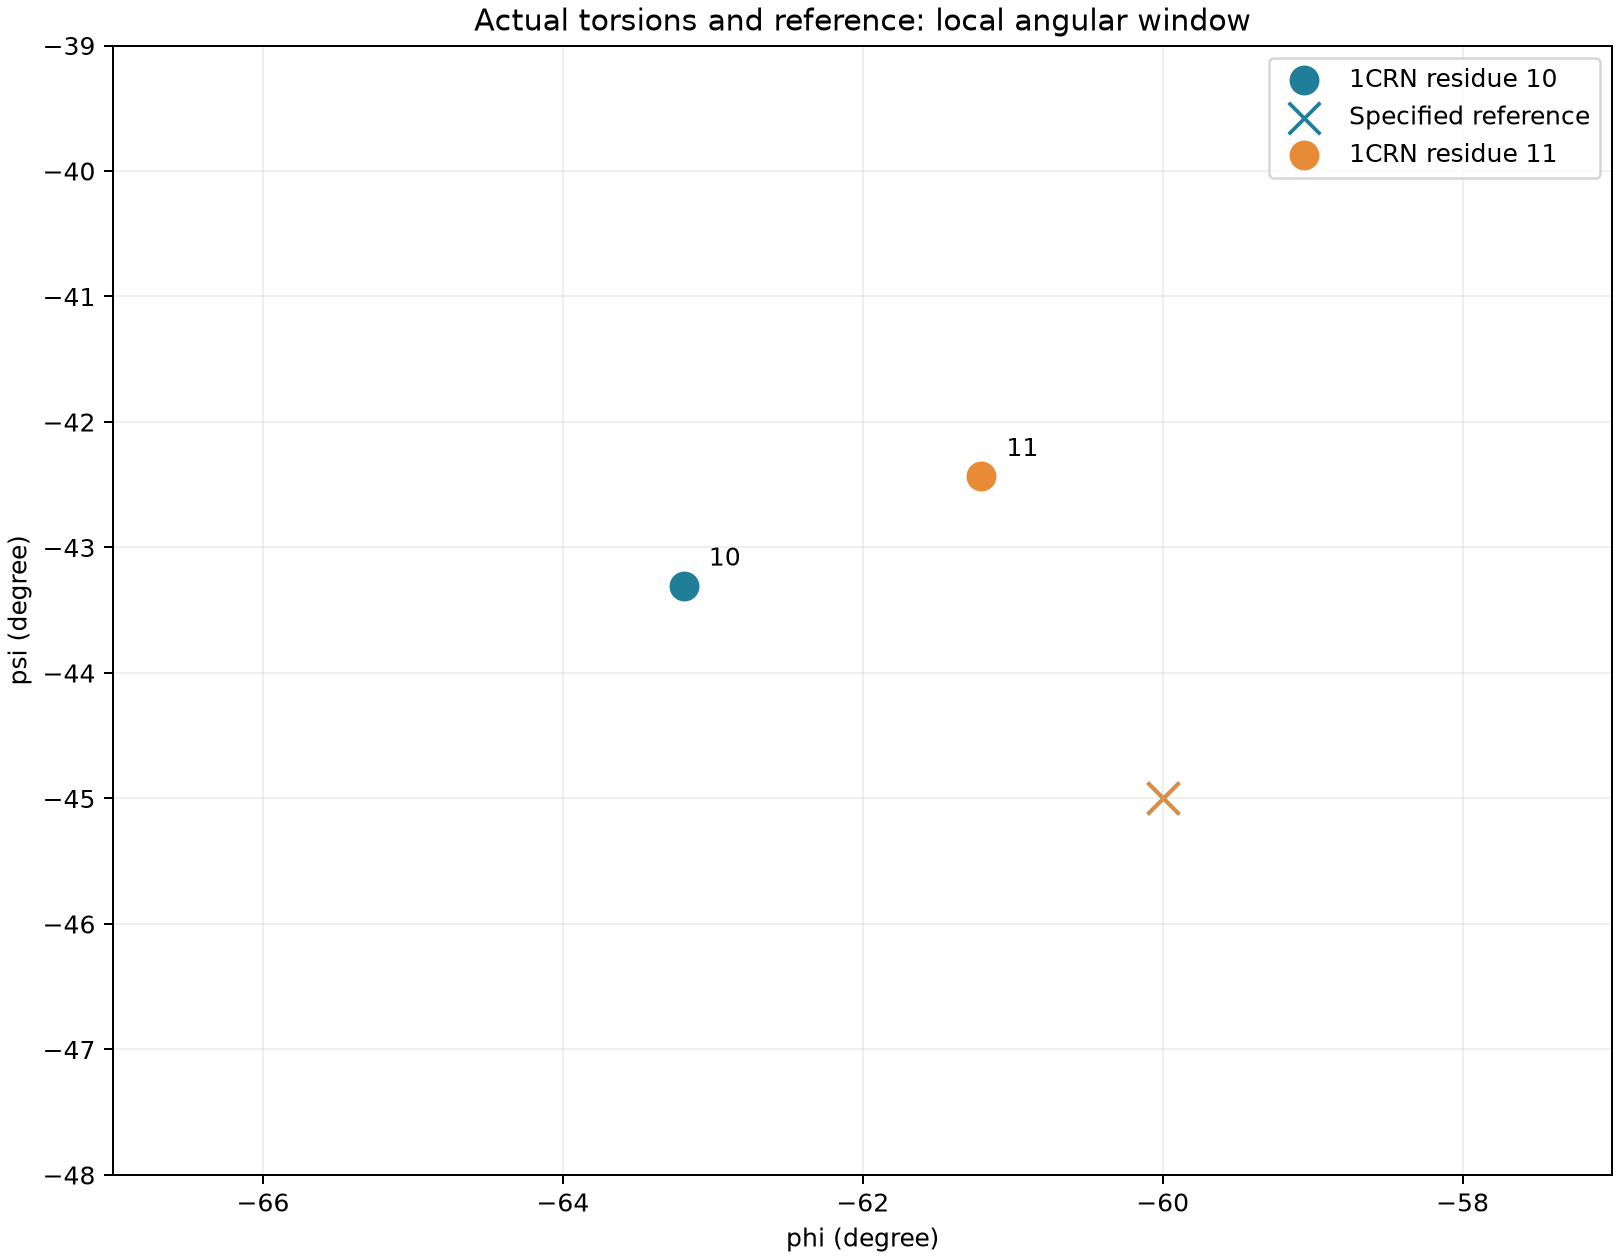
本例用MOLINFO识别主链,通过@phi-10、@psi-10选择10号残基的φ/ψ四原子组,11号残基同理。需要前后相邻残基才能构成相应二面角,不能把这个写法直接用于没有邻接原子的链端。
完整inputs/plumed.dat为:
UNITS LENGTH=nm ENERGY=kj/mol TIME=ps
MOLINFO STRUCTURE=structure.pdb MOLTYPE=protein
phi10: TORSION ATOMS=@phi-10 NOPBC
psi10: TORSION ATOMS=@psi-10 NOPBC
phi11: TORSION ATOMS=@phi-11 NOPBC
psi11: TORSION ATOMS=@psi-11 NOPBC
c_values: DIHEDRAL_CORRELATION ATOMS1=@phi-10,@phi-11 NOPBC
c: SUM ARG=c_values PERIODIC=NO
v: DIHEDRAL_CORRELATION ATOMS1=@phi-10,@psi-10 ATOMS2=@phi-11,@psi-11 NOPBC
DUMPVECTOR ARG=v FILE=correlations.dat STRIDE=1 FMT=%24.16e
dih: DIHCOR ATOMS1=@phi-10,@psi-10 ATOMS2=@psi-10,@phi-11 ATOMS3=@phi-11,@psi-11 NOPBC
ab: ALPHABETA ATOMS1=@phi-10 ATOMS2=@psi-10 ATOMS3=@phi-11 ATOMS4=@psi-11 REFERENCE1=-1.047197551196598 COEFFICIENT1=1.0 REFERENCE2=-0.7853981633974483 COEFFICIENT2=0.5 REFERENCE3=-1.047197551196598 COEFFICIENT3=2.0 REFERENCE4=-0.7853981633974483 COEFFICIENT4=1.5 NOPBC
b: RESTRAINT ARG=dih,ab AT=2,3 KAPPA=2,3
PRINT ARG=phi10,psi10,phi11,psi11,c,dih,ab,b.bias,b.force2 FILE=COLVAR STRIDE=1 FMT=%24.16e
DIHEDRAL_CORRELATION比较两个二面角的瞬时相似度,范围0到1:相同方向为1,相差π为0。它是几何描述量,不是两个角随时间的统计相关系数。本例当前安装使用编号ATOMS1得到向量,再用SUM把单个元素变为标量;读取单项结果时也沿用这一写法。
DIHCOR把三对角的相似度加起来,范围0到3。ALPHABETA分别计算每个角与参考角的余弦相似度,再乘相应系数求和。本例参考φ=−π/3、ψ=−π/4,权重为1、0.5、2、1.5,最大得分为5。这些是明确指定的教学参考,不是由本结构拟合出的参数;命令名也不意味着输出就是α/β残基比例。
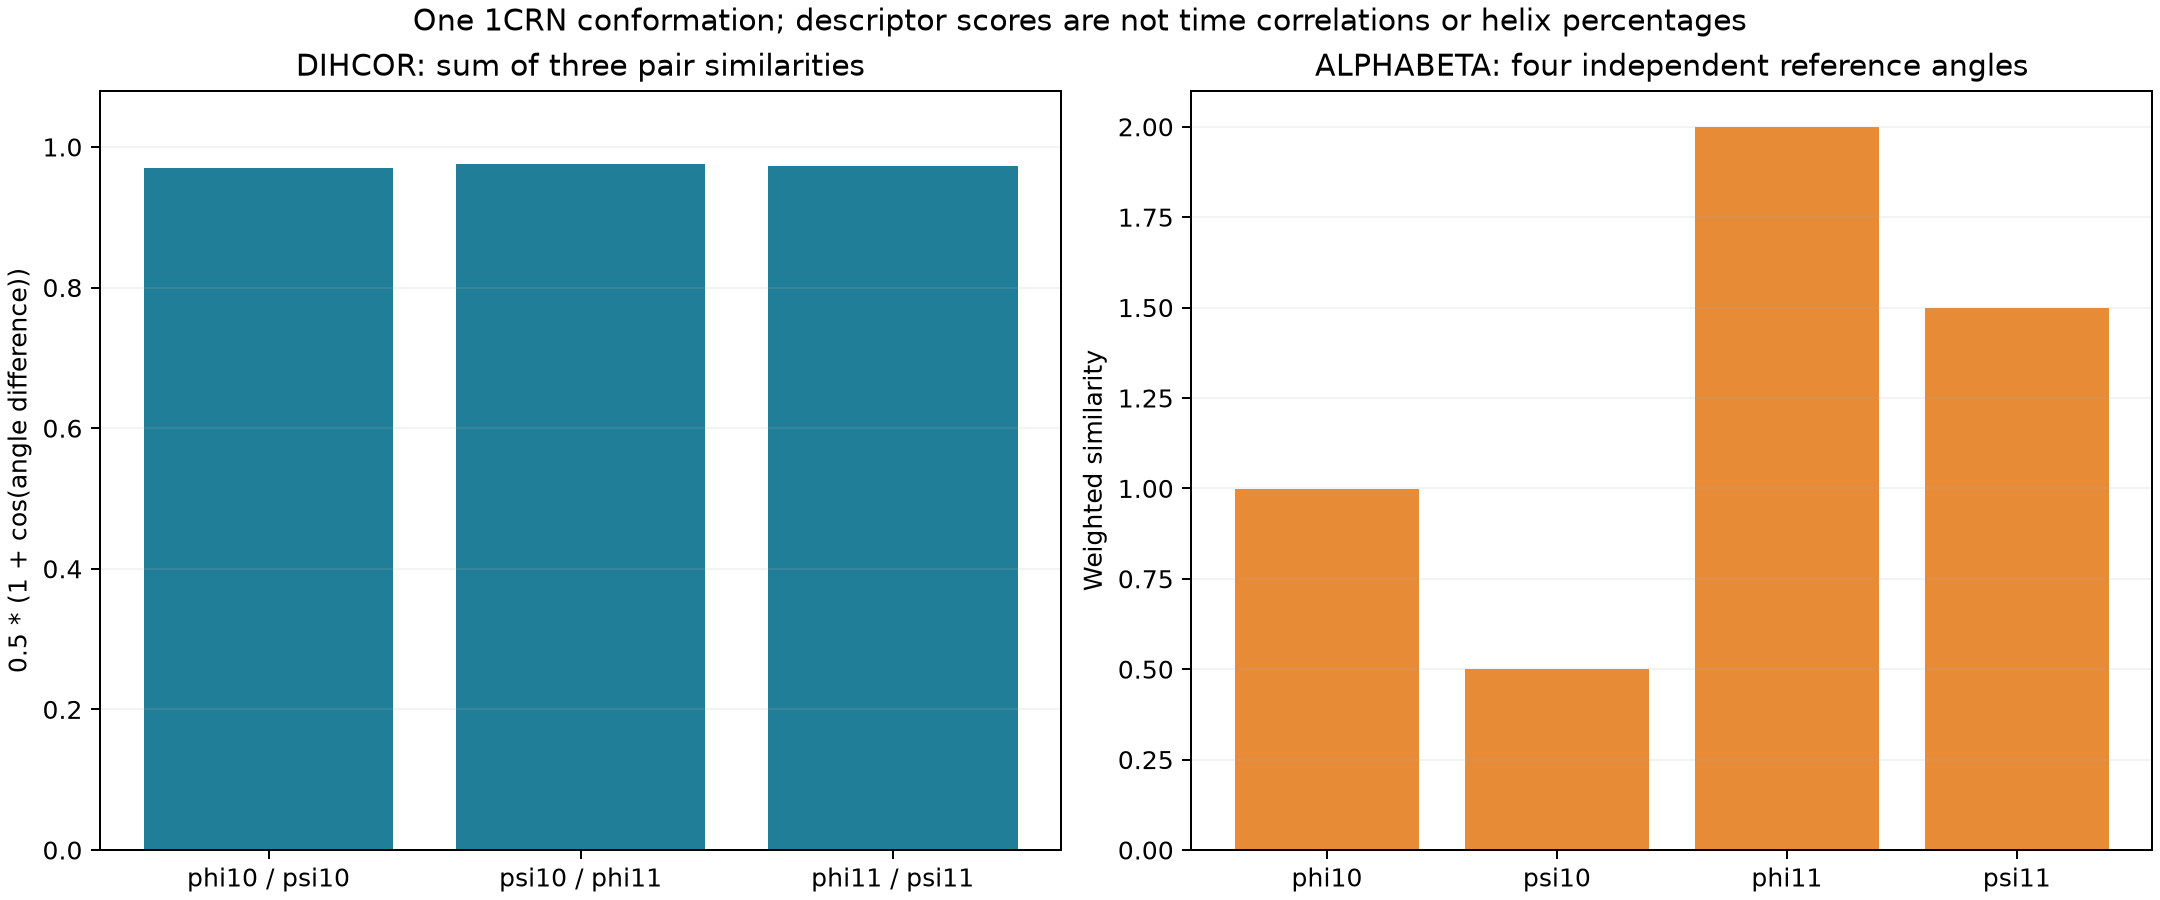
实际第1帧结果为:
| 输出 | 数值 | 含义 |
|---|---|---|
| phi10 | −1.10293310 rad | 10号残基φ角 |
| psi10 | −0.75578841 rad | 10号残基ψ角 |
| phi11 | −1.06829510 rad | 11号残基φ角 |
| psi11 | −0.74054907 rad | 11号残基ψ角 |
| c | 0.99970008 | phi10与phi11的相似度 |
| dih | 2.91934209 | 三对角的相似度之和 |
| ab | 4.99813730 | 四个角与参考的加权相似度之和 |
原生角输出为弧度,图中为了直观换算成度。比较角度时要处理±π的等价边界;这里的余弦比较在跨过该边界时仍连续,不应把接近+π和−π的两个角误判为差很远。
8 运行主链角度实例并查看偏置#
sbatch run.slurm
squeue -u "$USER"
# 完成后读新的输出
bash read.sh work-new analysis-new
bash plot.sh analysis-new
head -8 analysis-new/PLUMED-protein-dihedral-forces.csv
该模板需要可用CPU队列资源,预留56核而实际使用单线程;原生分析约0.6秒。已给出的参考数据可以直接读取。软件与编译环境与前面的二级结构例子相同,不需要重新编译插件。
输入最后的RESTRAINT分别对dih和ab施加谐偏置,目标为2、3,KAPPA为2、3。本例偏置能为6.834019 kJ/mol,只演示两个构象量如何连接到受力;不表示应在真实蛋白研究中采用这些目标与强度。
head -18 reference-results/original/COLVAR
head -8 reference-results/original/analysis.0.correlations.dat
COLVAR中四个角、单项相似度、两种求和指标和偏置能均有保存;逐对向量的前两帧写在analysis.0/1.correlations.dat,无前缀文件保留末帧。下载包的原子力CSV列出依赖这些主链角的原子及独立能量差分结果。
替换自己的蛋白时,先检查残基编号与主链完整性,再修改相邻角的组合、参考角和系数。读取/画图脚本针对本例10、11号残基及三帧数据,换体系后应同步修改。定义见DIHCOR与ALPHABETA官方说明。