
PLUMED的分段RMSD与独立叠合
从642原子的1CRN示例学习TER分段、整体与分段叠合、原子权重,以及可用于偏置的独立RMSD组合输入。
阅读本篇目录
下载七组完整输入、实际输出、读取绘图脚本、全部原子力和CSV(ZIP)。想比较蛋白各片段内部形变,又不希望把片段之间的相对转动当成内部变化,可以先分别叠合,再合并距离。本篇给出完整终端操作,也解释何时应保留整体RMSD。
1 先读取和画出已有结果#
解压进入plumed-multiblock-RMSD:
bash read.sh
bash plot.sh
head -8 analysis/PLUMED-multiblock-RMSD.csv
ls analysis/figures
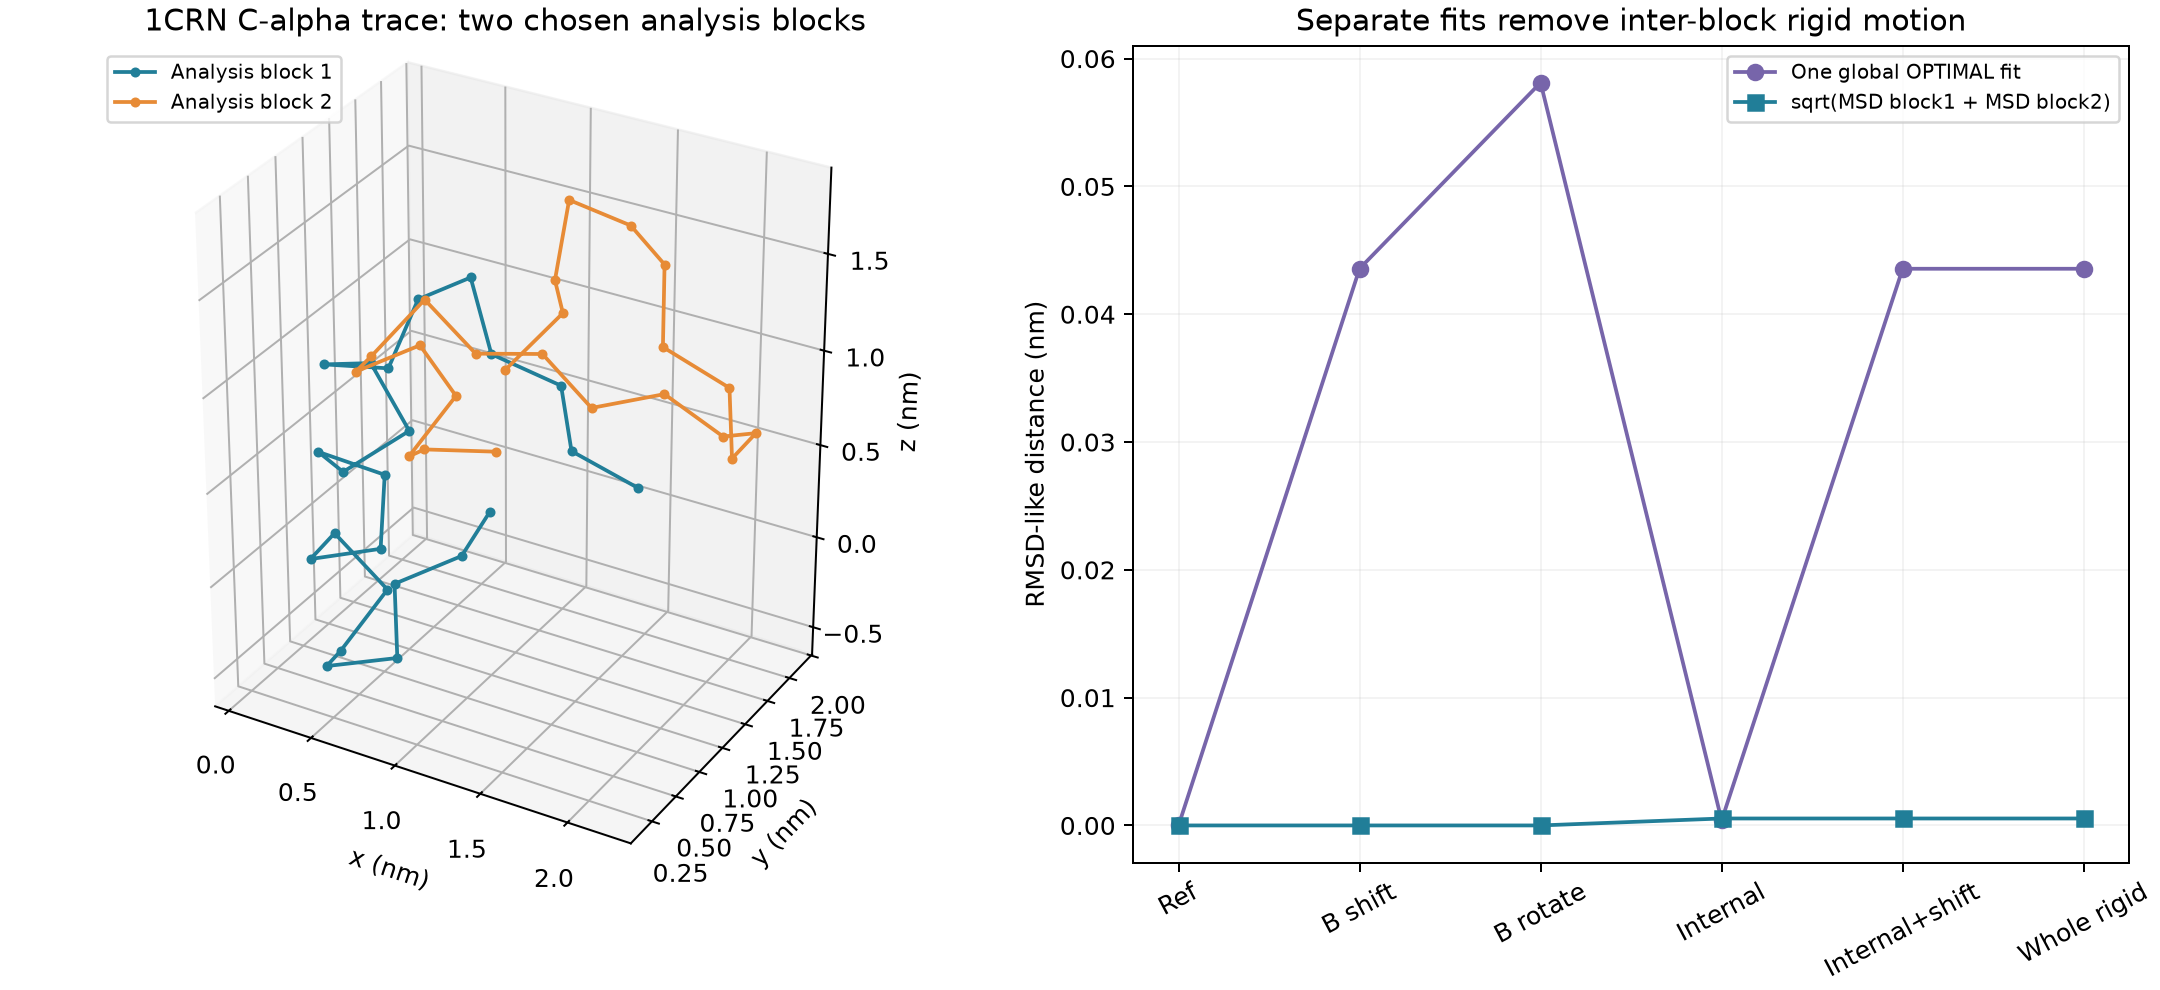
参考为1CRN结构,用GROMACS添加氢后共642个原子。本例人为把1–23号残基与24–46号残基分成两个分析片段;这个划分用于解释算法,不是在判断1CRN有两个天然结构域。
六帧为参考、后半段平移、后半段转动、一个CA原子的明确位移、组合变化和整体刚体副本。它们是明确构造的几何测试帧,不是平衡MD轨迹,也不是新的弛豫构型。
2 理解输出距离的含义#
每一段单独计算归一化MSD,然后相加:m = MSD₁ + MSD₂,单位nm²;输出r = sqrt(m),单位nm。这里各段的系数都是1,不是把所有原子混在一起平均,也不是RMSD₁ + RMSD₂。
| 明确的坐标变化 | 分段距离r(nm) | 整体OPTIMAL RMSD(nm) |
|---|---|---|
| 参考 | 2.921622e-16 | 1.894045e-16 |
| 后半段平移0.1 nm | 3.247434e-16 | 0.04356832 |
| 后半段旋转0.15 rad | 6.631782e-16 | 0.05811997 |
| 残基10的CA移动0.01 nm | 0.0005444374 | 0.0003941945 |
| 内部移动加后半段平移 | 0.0005444374 | 0.04355721 |
| 上一帧整体旋转平移 | 0.0005444374 | 0.04355721 |
后半段只作平移或旋转时,其内部构型不变,所以分段OPTIMAL距离接近0;整体距离会反映两段相对位置的改变。如果研究对象恰恰是铰链开合或片段间重排,应同时看整体RMSD、片段间距离或取向,不能只看分段RMSD。
3 准备参考文件和TER分界#
/public/toolkit/miniconda3/envs/ase-3.29.0/bin/python prepare-inputs.py
head -8 inputs-prepared/optimal-analysis/domains.pdb
grep -n '^TER' inputs-prepared/optimal-analysis/domains.pdb
sed -n '333,341p' inputs-prepared/optimal-analysis/domains.pdb
cat inputs-prepared/optimal-analysis/plumed.dat
domains.pdb的两组ATOM记录之间有TER,最后也有TER。原子编号保留1–642,与轨迹一致。不要为了分块而让第二段的原子编号重新从1开始。PDB坐标列使用Å;XYZ文件使用nm,运行时明确--length-units nm。
准备脚本根据原始PDB切分参考、设置权重,并将附带的六帧几何坐标写成XYZ,再与实际计算输入逐字节比较。它不执行MD。whole.pdb保留同一批原子供整体叠合;block1.pdb和block2.pdb供显式组合使用。
PDB中的occupancy列控制叠合权重,beta列控制位移权重;本例两列保持相同。全原子组均设1,heavy-analysis和heavy-explicit-bias将氢的两列权重设0。权重会在每一段内归一化,因此仅去掉氢也会改变剩余原子的平均权重。
4 用MULTI_RMSD分析已有轨迹#
inputs/optimal-analysis/plumed.dat:
UNITS LENGTH=nm ENERGY=kj/mol TIME=ps
m: MULTI_RMSD REFERENCE=domains.pdb TYPE=OPTIMAL SQUARED NOPBC
r: MULTI_RMSD REFERENCE=domains.pdb TYPE=OPTIMAL NOPBC
g: RMSD REFERENCE=whole.pdb TYPE=OPTIMAL SQUARED NOPBC
v: CUSTOM ARG=m FUNC=5*x PERIODIC=NO
PRINT ARG=m,r,g FILE=COLVAR STRIDE=1 FMT=%24.16e
m是分段MSD之和,r是其平方根,g是同一642原子的整体OPTIMAL MSD。v在分析组中仅作算术计算,没有连接BIASVALUE,不会施加偏置。
包中还实跑了SIMPLE、MULTI-OPTIMAL-FAST以及重原子权重组。SIMPLE只消除平移;OPTIMAL同时消除转动。当前快捷命令使用FAST时的完整写法为TYPE=MULTI-OPTIMAL-FAST。
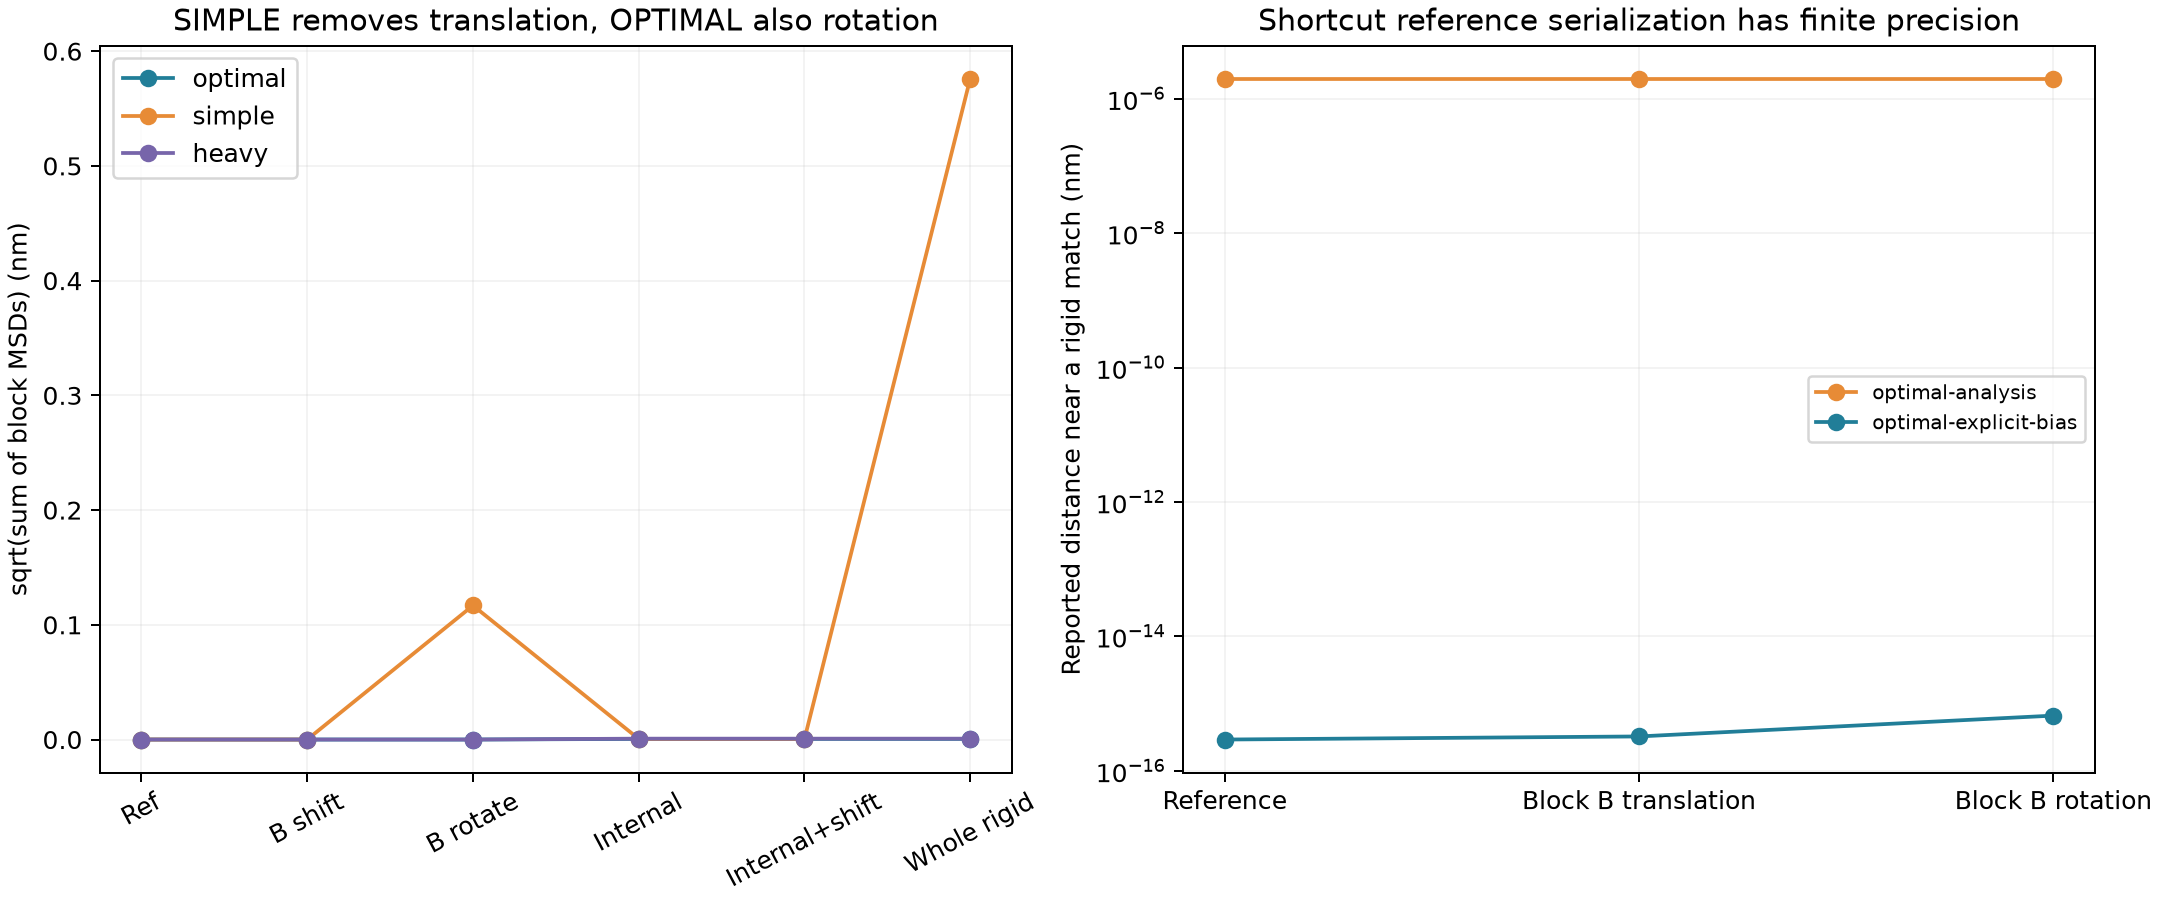
快捷命令在内部构造参考常量时有文本精度损失,本例完美刚体匹配仍显示约1.99×10⁻⁶ nm的小残差;显式PDB逐段RMSD的结果接近浮点零。这一差别无需解释为真实结构变形。FAST在近零匹配处也可能有极小负MSD,直接开平方会出现NaN;本例推荐用OPTIMAL,不通过截断或取绝对值掩盖这个问题。
5 需要施加偏置时,使用独立RMSD组合#
当前集群安装中,本例原版MULTI_RMSD连接偏置后的运行会中止。因此这里把它用于轨迹分析;需要偏置时,使用已实际运行的独立RMSD加COMBINE输入。该方式使用原版PLUMED命令,无需改动公共软件。
inputs/optimal-explicit-bias/plumed.dat:
UNITS LENGTH=nm ENERGY=kj/mol TIME=ps
a: RMSD REFERENCE=block1.pdb TYPE=OPTIMAL SQUARED NOPBC
c: RMSD REFERENCE=block2.pdb TYPE=OPTIMAL SQUARED NOPBC
m: COMBINE ARG=a,c COEFFICIENTS=1,1 PERIODIC=NO
r: CUSTOM ARG=m FUNC=sqrt(x) PERIODIC=NO
g: RMSD REFERENCE=whole.pdb TYPE=OPTIMAL SQUARED NOPBC
v: CUSTOM ARG=m FUNC=5*x PERIODIC=NO
b: BIASVALUE ARG=v
PRINT ARG=m,r,g,b.bias FILE=COLVAR STRIDE=1 FMT=%24.16e
a、c分别读取两段PDB并计算MSD;m按1:1相加;演示能量为V=5m,偏置系数在本例单位下为5 kJ·mol⁻¹·nm⁻²。这个系数仅用于解释输入与原子力,不是其他体系的推荐采样参数。r用于显示,不在偏置链上;在精确零点附近,对平方根距离施加偏置需要另外考虑导数定义。
三组显式偏置分别为OPTIMAL、SIMPLE、OPTIMAL重原子;配套CSV保留每组六帧、全部642个原子的偏置力。重原子组的氢原子偏置力为0。这里验证的是固定轨迹上的偏置值与力,没有据此宣称完成MD采样或自由能计算。
6 在自己的目录重新运行#
cat run.slurm
sbatch run.slurm
# 作业结束后
bash read.sh work-new analysis-new
bash plot.sh analysis-new
head -8 analysis-new/PLUMED-multiblock-forces.csv
脚本只在新的work-new目录运行七组输入,不覆盖附带的参考结果。CPU模板预留56核,实际使用单线程、不使用GPU;每组原生轨迹分析约0.6秒。需要有可用CPU队列资源。
单组运行的核心命令为:
source environment.sh
# 先复制需要的inputs子目录到自己的新工作目录
plumed driver --plumed plumed.dat --ixyz trajectory.xyz \
  --length-units nm --dump-forces forces.xyz \
  --dump-forces-fmt %24.16e
使用PLUMED2.10.1,编译器Intel oneAPI C++2024.2.1、IntelMPI2021.13。NumPy负责独立叠合和数据读取,Matplotlib绘图。包内读取器针对642原子、六帧和两个片段;换体系时相应修改原子数、帧数、片段范围与文件名。
7 换成自己的体系时#
先根据研究目的选片段,确认参考和轨迹的编号、顺序、化学组成一致,再决定是否仅用重原子。跨周期边界的分子应先正确重建。本例是完整有限片段,使用NOPBC;不能不处理跨盒分子就照搬这个选项。
官方已将MULTI_RMSD作为简化快捷接口,并建议复杂定义使用显式命令组合。参见官方MULTI_RMSD说明和对应版本实现。