
PLUMED VES的ADAM本地插件与三个优化分支
在个人目录构建独立Action,实际运行ADAM、AMSGrad和权重衰减,检查EPSILON、变化梯度及8次更新后的系数,不替换公共程序。
阅读本篇目录
下载插件源码、完整输入、原生结果、读取及绘图程序(ZIP)。本篇补充平均SGD等优化器中提到的ADAM参数限制:当前2.10.1原版虽然读取EPSILON,其两处分母却使用了另一个全局常量。本篇把这两处改为已读取的值,并注册成独立的OPT_ADAM_LOCAL,通过LOAD在个人目录使用,公共OPT_ADAM和软件安装保持原样。
1 先读取三个实际结果#
解压进入plumed-ADAM-local:
bash read.sh
bash plot.sh
cat analysis/PLUMED-ADAM-local-iterations.csv
以上只读已有结果,不需要先编译插件。三组各实际处理9帧指定距离、进行8次系数更新;这是优化算法的短例,不是受偏置推动的MD轨迹,也不是收敛自由能采样。
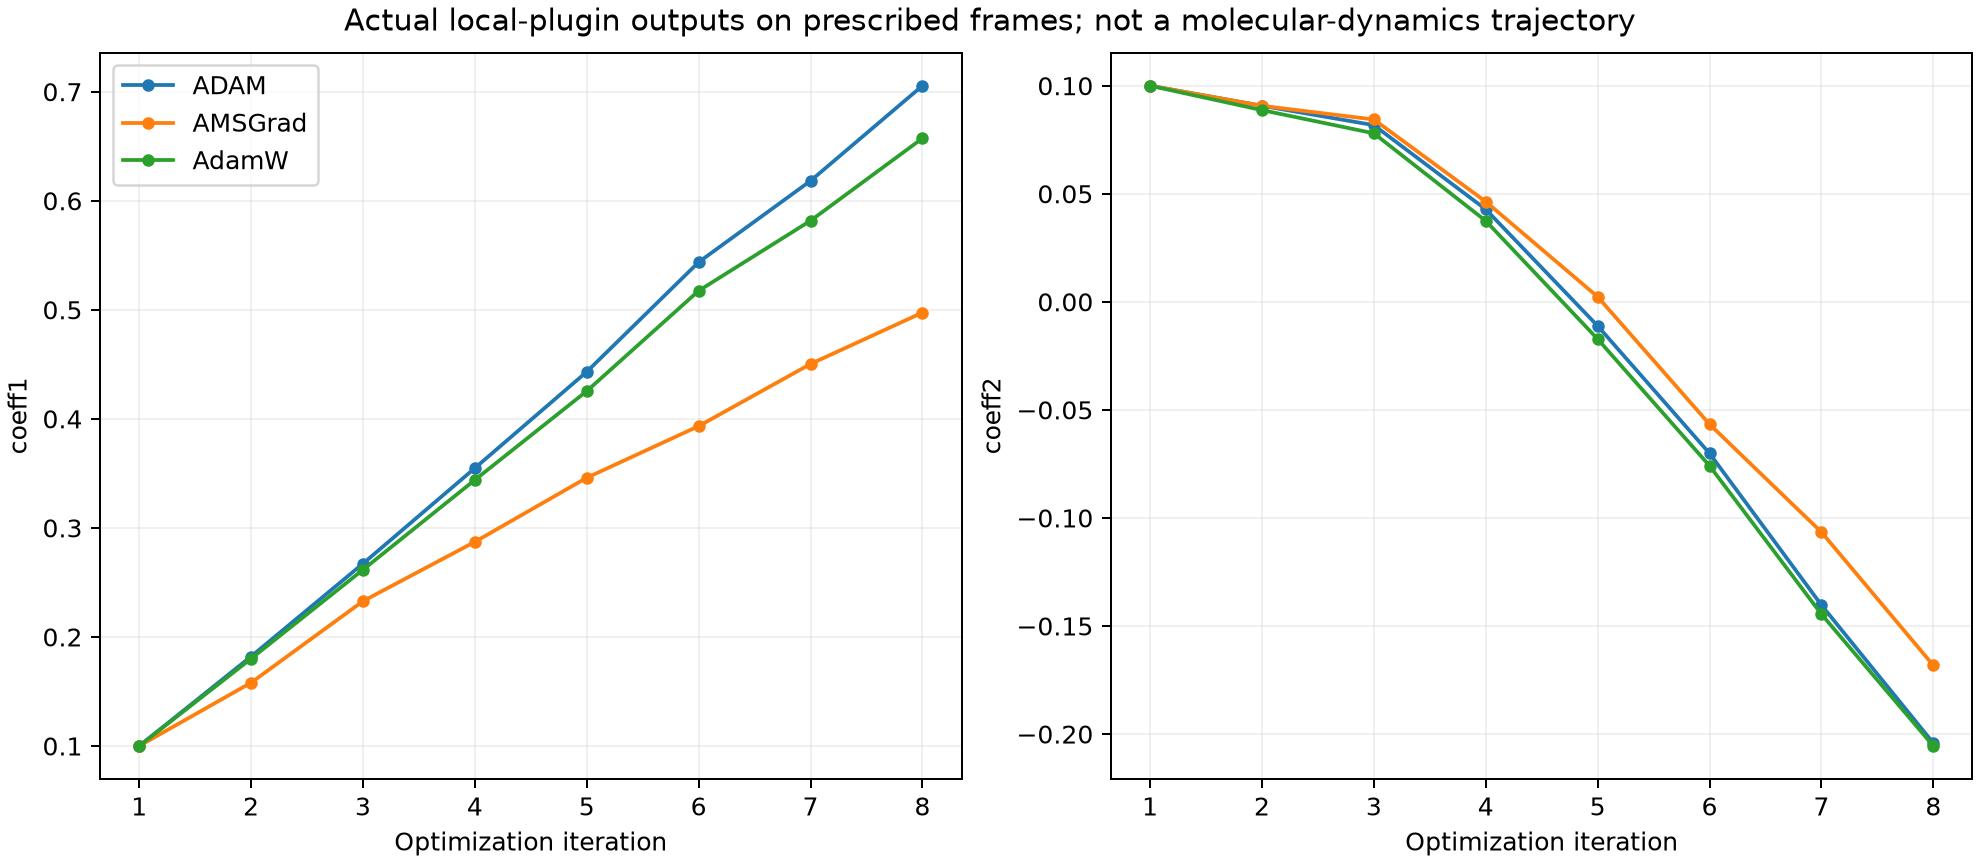
最后两项系数:ADAM约0.705499、−0.204194;AMSGrad约0.497449、−0.168244;加入权重衰减后约0.657293、−0.205524。每一步系数与独立递推在10⁻⁹绝对误差内吻合。
2 自己编译、提交一次#
在资料包顶层执行:
sbatch run.slurm
CPU模板按56核整节点规则申请,原生编译和计算均使用单进程、单线程。先在个人目录用plumed mklib构建Opt_Adam_Local.so,然后在新的work-new/ADAM、work-new/AMSGrad、work-new/AdamW分别运行,已有结果时停止。资料包不附二进制插件。
在已经分配到的兼容CPU资源中,可分步操作:
bash build.sh
bash run.sh
bash read.sh work-new analysis-new
bash plot.sh analysis-new
build.sh配置当前PLUMED2.10.1的编译环境,调用原生mklib;若系统只有版本化libz.so.1,它只在资料包自己的build-libs/建立链接,供本次编译查找,不修改系统库。源码与构建路径针对本篇2.10.1,换其他PLUMED版本不能直接复用已编译的.so。
配套环境来自CP2K2026.2依赖构建,Intel oneAPI2024.2、Intel MPI2021.13、MKL顺序库和GSL2.8;不使用GPU。插件保留上游LGPL许可及版权说明,附源代码与补丁。
3 完整PLUMED输入#
新计算的inputs/ADAM/plumed.dat:
LOAD FILE=../../Opt_Adam_Local.so
UNITS LENGTH=nm ENERGY=kj/mol TIME=ps
d: DISTANCE ATOMS=1,2 NOPBC
bf: BF_LEGENDRE ORDER=2 MINIMUM=0 MAXIMUM=2
ves: VES_LINEAR_EXPANSION ARG=d BASIS_FUNCTIONS=bf TEMP=300 GRID_BINS=400 GRID_FMT=%24.16e
opt: OPT_ADAM_LOCAL BIAS=ves STRIDE=1 STEPSIZE=0.1 BETA_1=0.9 BETA_2=0.5 EPSILON=1e-8 COEFFS_FILE=coeffs.data COEFFS_OUTPUT=1 COEFFS_FMT=%24.16e GRADIENT_FILE=gradient.data GRADIENT_OUTPUT=1 GRADIENT_FMT=%24.16e BIAS_OUTPUT=1 FES_OUTPUT=1 TARGETDIST_AVERAGES_OUTPUT=1
PRINT ARG=d,ves.bias,ves.force2 STRIDE=1 FILE=colvar.data FMT=%24.16e
LOAD相对路径对应work-new/ADAM,两级上方才是插件所在资料包顶层。单独整理自己的目录时,相应修改这个路径;只复制plumed.dat而漏掉插件,会无法找到本地Action。
距离CV的定义区间为0到2 nm,二阶Legendre基有3项。均匀目标对应的基函数平均为1、0、0;常数项梯度为0,系数保持0。三组使用相同9个距离(nm):
1.8, 1.8, 1.0001, 1.5773502691896257, 0.99,
1.4, 1.02, 1.55, 1.001
每帧两原子的位置是(0,0,0)和(d,0,0),完整XYZ在各输入目录。使用NOPBC,不把这个二原子几何样例解释成特定分子的势能面。
STRIDE=1每步更新;这里特意用BETA_2=0.5让变化梯度及最大方差分支容易看清,不是生产采样参数推荐。要用实际动力学优化,应另行检查步长、平均长度、采样质量和自由能收敛。
4 两个变体怎样启用#
与ADAM相同的输入,只在优化器行末分别增加:
# AMSGrad
AMSGRAD

# 本版本权重衰减
ADAMW_WEIGHT_DECAY=0.02
这两段表示追加到同一条opt:行的选项,不是单独的新Action。附件已经分别写好三份完整输入,不需要自己拼接。
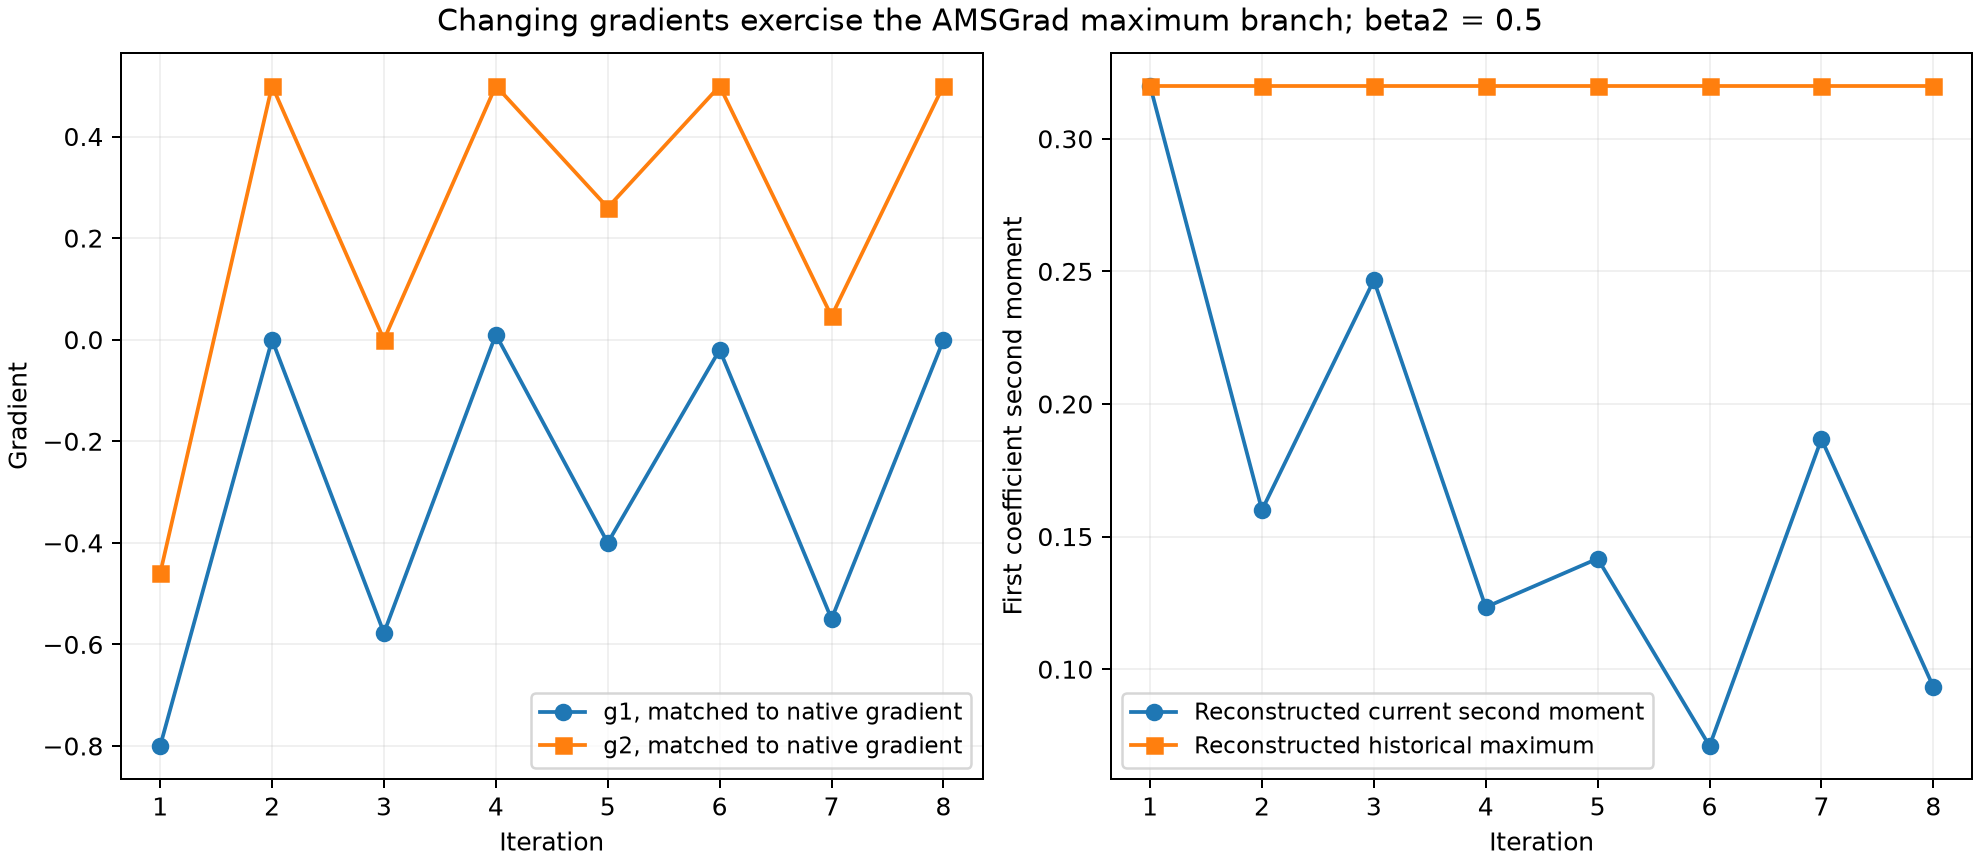
AMSGrad保留二阶矩的历史最大值;当当前二阶矩下降时,两者不同,本例实际触发了这个分支。若一直输入常数梯度,可能看不出AMSGrad与ADAM的差异。
当前上游权重衰减实现是在每次更新前把系数乘1−ADAMW_WEIGHT_DECAY,本例就是0.98;它不是再乘学习率后的衰减系数。选择参数时按这个实际定义理解,不能与其他机器学习库的同名参数直接互换。
5 检查哪些文件#
head -16 work-new/AMSGrad/gradient.data
tail -16 work-new/AMSGrad/coeffs.data
head -6 work-new/AMSGrad/colvar.data
gradient.data保存实际梯度;coeffs.data保存系数及梯度一阶动量;二阶矩与历史最大值由配套工具按已记录梯度独立重建。colvar.data的偏置使用本步更新前的系数,不能把第8次更新后的系数直接套到第8帧偏置上。每个输出网格也与相应系数重建的偏置及导数进行了比较。
本地修正只解决这里的EPSILON分母问题。ADAM及变体仍是上游实验性实现,不支持正常重启续算;已有优化状态不能仅靠复制系数就声称完整恢复动量和方差。需要稳定的常规路线,可继续使用平均SGD等优化器。