
Wannier90矩阵导出与简并权重
实算对照普通与已除简并权重的HR、位置矩阵和TB文件,说明如何正确恢复能带,以及b向量输出的用途。
阅读本篇目录
把Wannier90矩阵交给自己的脚本或其他程序时,需要先确认:文件中的简并权重是否已经应用过。同一模型可以有不同的文件表示;矩阵元素看起来不同,并不表示物理模型不同。重复除权重,则会改变恢复出来的能带。
1.先读取两组实际输出#
下载完整输入、矩阵、CSV和画图脚本,保存为example.zip:
python3 -m zipfile -e example.zip .
cd wannier-ndegen-exports
bash read.sh
bash plot.sh
两组目录分别为native-weights与weights-applied,都来自同一Si模型:2个Si原子、12条原始DFT能带、8个Wannier函数、4×4×4粗k网格。这里复用已经完成的局域化检查点,只增加矩阵导出,没有重新做DFT或局域化。
head -n 12 reference-results/native-weights/silicon_hr.dat
head -n 12 reference-results/weights-applied/silicon_hr.dat
ls analysis
脚本生成Wannier-realspace-export.csv与Wannier-degeneracy-bands.csv。前者对比实空间矩阵,后者列出5个指定k点、每点8条带的恢复结果。
2.在已有win里增加哪些设置#
保留原本匹配的晶胞、k点、投影与窗口设置,在完成局域化的工作目录中使用:
restart = plot
use_ws_distance = false
write_hr = true
write_rmn = true
write_tb = true
write_bvec = true
write_ndegen_applied = false
restart=plot读取已有检查点进行输出。资料包提供了完整silicon.win和匹配的文本检查点、AMN、MMN、EIG文件,不需要手工补写64个k点。
在第二个独立目录中,仅把最后一项改为:
write_ndegen_applied = true
本例两组都明确采用use_ws_distance=false,因此实空间R列表相同,共93个R向量。这一点很重要:使用use_ws_distance=true时还涉及按Wannier中心的Wigner–Seitz映射,不能把本例的固定R列表照搬过去。
3.重新导出自己的文件#
bash prepare.sh
ls work-new/native-weights
bash run.sh
bash read.sh work-new analysis-new
bash plot.sh analysis-new figures-new
prepare.sh只创建新工作副本,不覆盖已有结果。run.sh依次处理两个目录,核心终端操作为:
module load wannier90/4.0.3-serial
cd work-new/native-weights
w90chk2chk.x -import silicon
wannier90.x silicon
-import把资料包的文本检查点转换成本机二进制格式;不要只改文件后缀。对于自己的体系,应先完成对应的DFT接口和局域化,而不是把本例检查点用于其他结构。
该步骤使用CPU,不会调用GPU。集群独立版为Wannier90 4.0.3,oneAPI2024.2 ifx、MKL LP64 sequential、AVX2构建。生产任务使用yskit对应的Wannier90提交模板,把上述命令放在申请到的Slurm资源中执行。
4.四种文件各有什么用途#
| 文件 | 主要内容 | 读取时注意 |
|---|---|---|
silicon_hr.dat |
实空间Hamiltonian,单位eV | 第2行Wannier数,第3行R向量数,随后为简并权重及矩阵块 |
silicon_r.dat |
位置算符的三个分量,单位Å | 默认模式自身没有独立简并权重块,需与对应模型信息一起处理 |
silicon_tb.dat |
晶格、Hamiltonian和位置矩阵的合并输出 | 包含简并权重;数值打印格式与独立HR文件不同 |
silicon.bvec |
每个k点的有限差分b向量及其权重 | 不是能带路径;相邻k点的向量排列顺序可以不同 |
本例silicon.bvec包含64个k点,每点8个b向量。分析脚本按加权向量集合核对,并检查每个k点的完备性张量,不要求文件中相同的行号对应相同方向。
旧参数hr_plot已被官方标为不再使用,新输入直接使用write_hr。完整参数语义见Wannier90官方参数说明。
5.权重只处理一次#
默认输出保留原始H(R)和权重g(R)。本例的普通插值为:
Hk = sum(np.exp(2j*np.pi*np.dot(k, R)) * HR / g
         for R, HR, g in blocks)
energies = np.linalg.eigvalsh(Hk)
开启write_ndegen_applied=true后,输出的是已经除过权重的矩阵,HR文件权重块全部为1。对应做普通傅里叶求和即可:
Hk = sum(np.exp(2j*np.pi*np.dot(k, R)) * HR
         for R, HR in applied_blocks)
这里k使用倒易晶格分数坐标,R是整数晶格向量。两种表示不要混合:不能拿第二组的矩阵,再除第一组的旧权重。若通用读取器始终除当前HR文件自带的权重也可以,因为第二组权重已全为1。
位置矩阵同样会预先除权重。开启Wigner–Seitz距离修正时,官方实现还会展开R列表;已经展开、加权的文件不能再额外应用旧WS映射。与其他程序交换模型前,应确认接收程序接受哪一种约定。
6.这次实际相差多少#
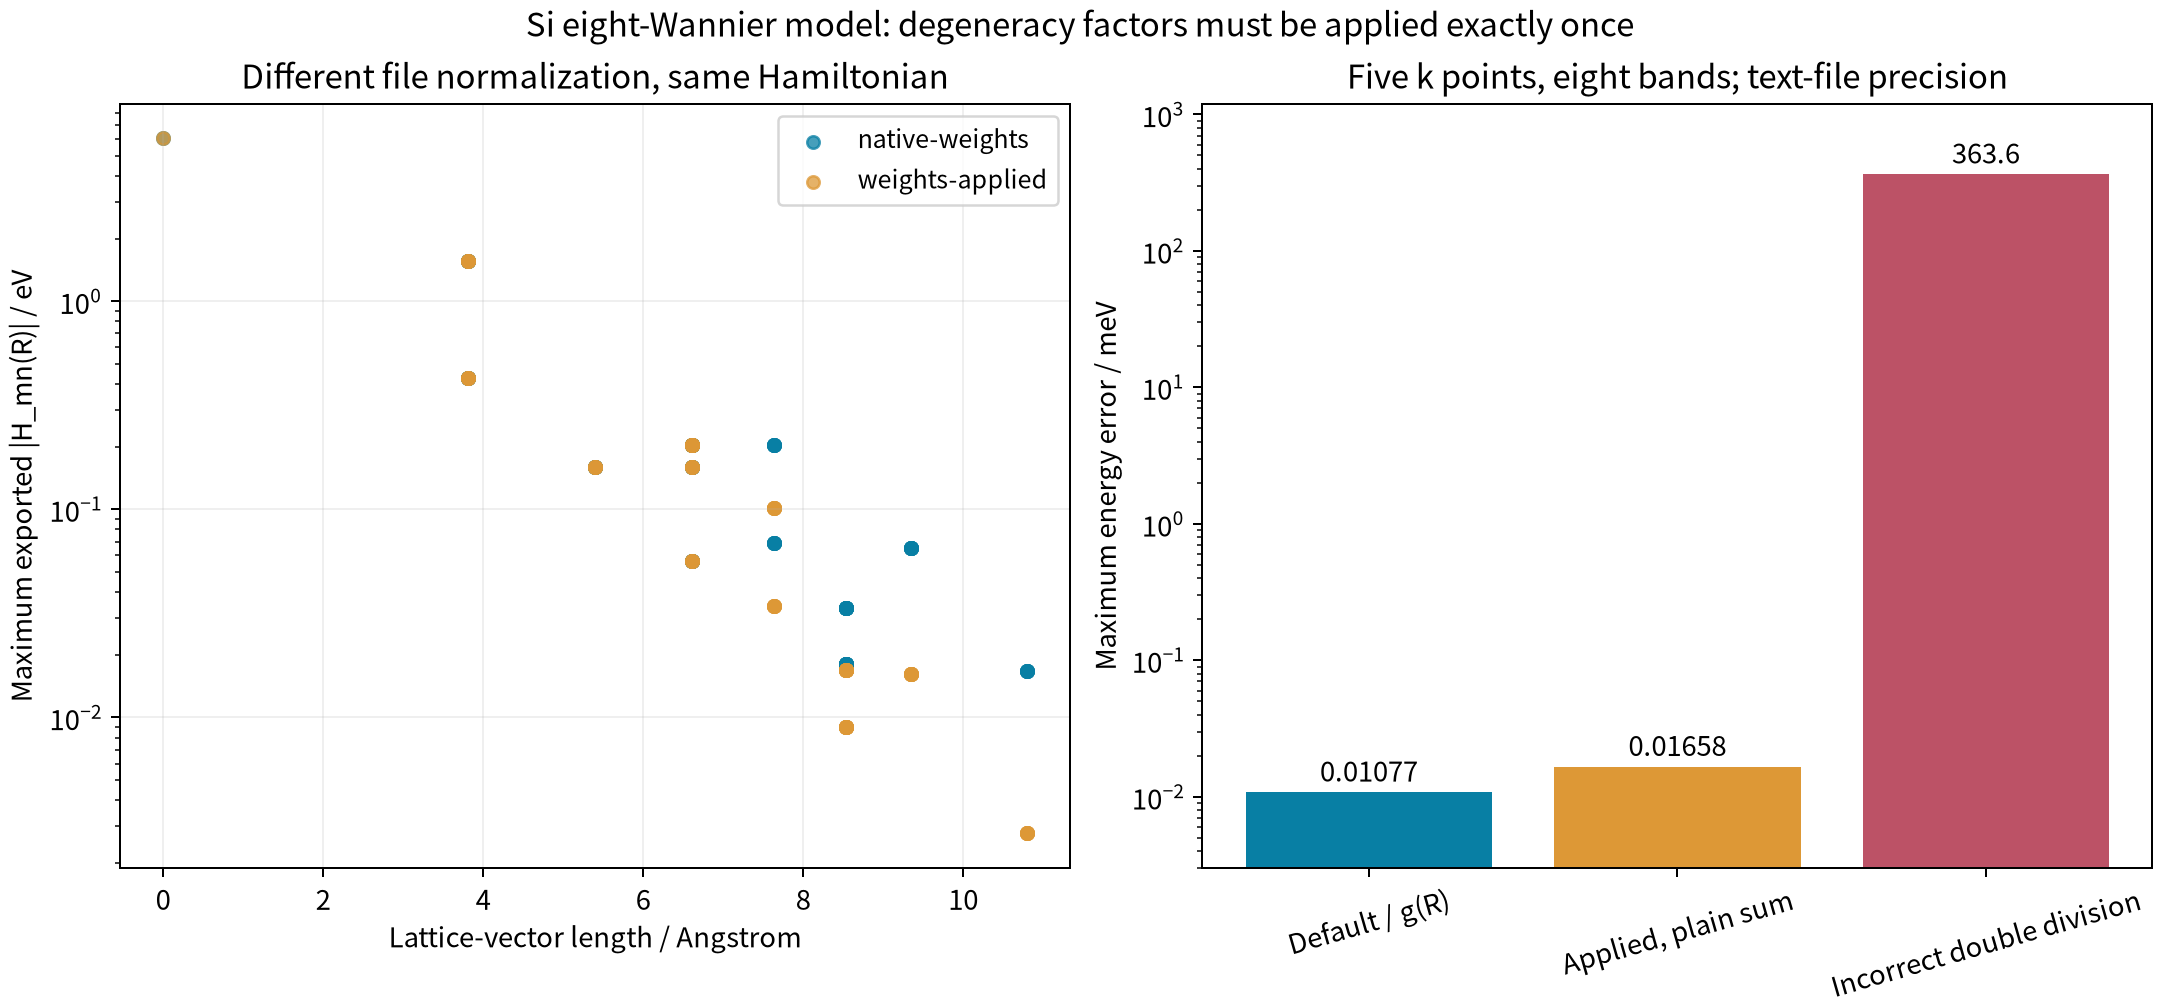
用同一份全精度模型作参照,在5个指定k点比较全部8条带,最大绝对差异如下:
| 读取方式 | 最大能量差/eV |
|---|---|
| 默认矩阵,除文件权重一次 | 0.0000107698 |
| 已应用权重的矩阵,直接求和 | 0.0000165786 |
| 错误示范:已应用权重后又除旧权重 | 0.3635888021 |
前两项的小差异来自文本矩阵有限的打印精度,不代表再次局域化产生了变化;两种正确表示互相比较的最大差异约0.0000101642eV。最后一项是对同一矩阵故意重复除权重的脚本对照,不是第三次原生计算。
read.py还逐项核对HR、位置矩阵、TB合并文件之间的关系。正式使用自己的模型时,同样建议先在几个k点恢复能带,与原生Wannier90输出对照,再开展后续计算。
hr_cutoff和dist_cutoff属于特定插值/输运路径的截断选项,不能仅凭write_hr=true就认为导出的Hamiltonian已经按它们截断。本篇专门讨论文件导出和简并权重,不把两种表示的差别解释成实空间截断效应。