
LAMMPS Kokkos实操:P100与V100上的高斯网格和局部统计
两种GPU各八组真实静态实例,完整展示高斯网格、局部组成与球形邻域统计的输入、Slurm提交、数据提取和画图。
阅读本篇目录
本篇用P100 16G与V100 16G各运行八组输入,演示三个明确的Kokkos样式:gaussian/grid/local/kk、composition/atom/kk和ave/sphere/atom/kk。前者把原子结构转换为分元素高斯网格,后两者提取每个原子邻域的组成和平均量。
所有输入都是run 0:位置与指定速度固定,只计算描述符,不积分轨迹。下面的数据说明如何运行、读取和理解这些输出,不能据此推断生产分子动力学的速度、GPU性价比或电子密度精度。
1.先看已有结果#
下载两种GPU的完整实例包,解压进入lammps-kokkos-fields:
bash read.sh
bash plot.sh
head -n 12 analysis/LAMMPS-Kokkos-parity-summary.csv
无需先申请GPU,就能读取包内的真实计算结果并画图。p100/reference-results与v100/reference-results分别保留对应平台的完整输入和原生输出,cpu-reference保留相同模型的CPU参考数据。读取和画图不会重新计算。
根目录两份CSV分别按条件汇总、按输出列细分CPU/GPU数值差异。更具体的网格值和逐原子数据位于analysis/p100/gaussian、analysis/p100/local及对应的v100目录。
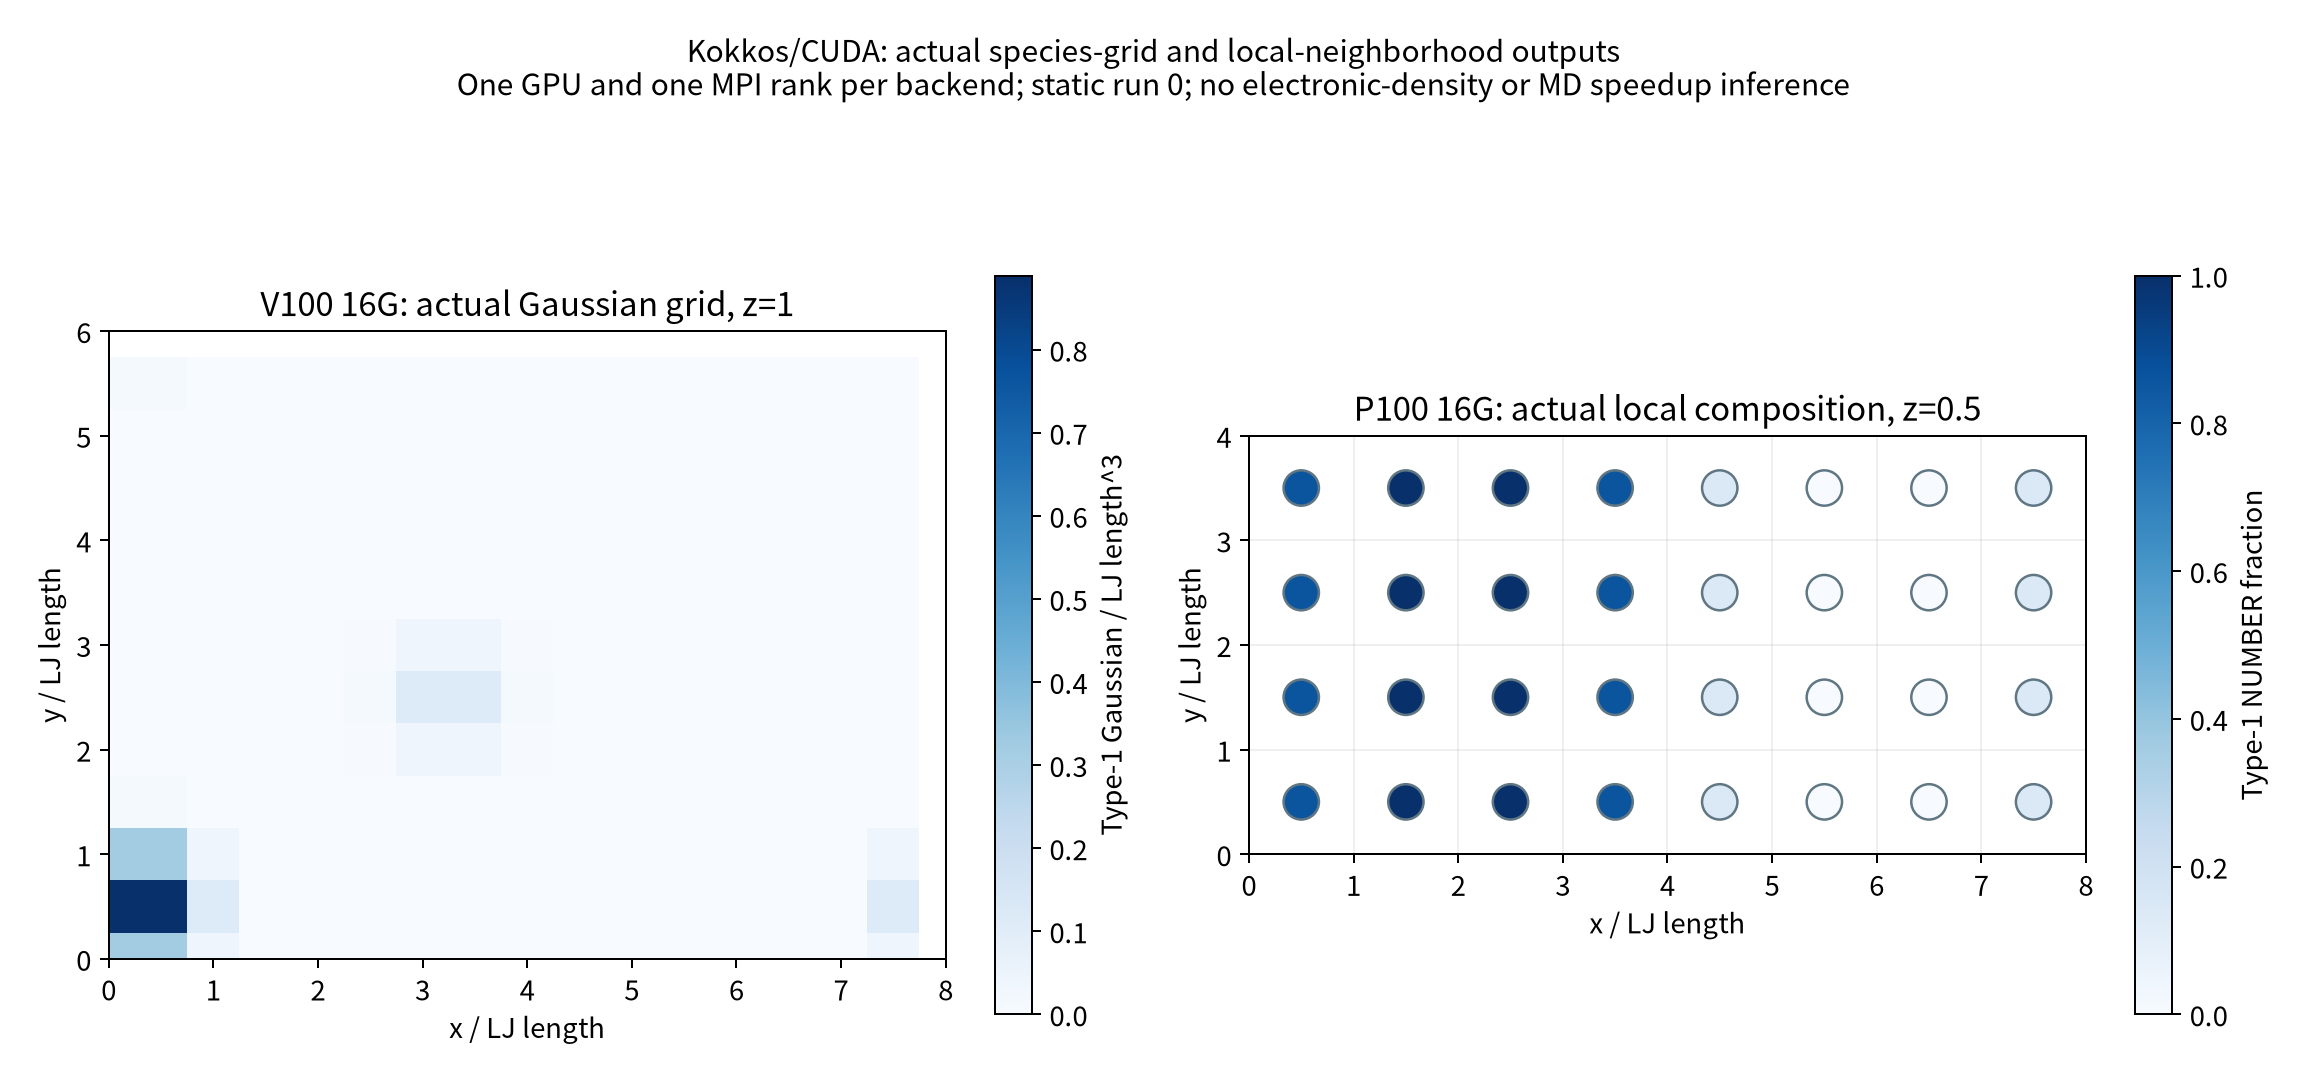
左图取V100的细网格z=1切片,右图取P100的局部组成z=0.5切片。高斯网格的颜色是结构描述符密度;局部组成的颜色是1号类型的原子数分数。两者代表不同的量。
2.准备输入,再通过Slurm提交#
先创建新目录:
bash prepare.sh
它分别创建p100/work-new与v100/work-new,拒绝覆盖已有结果。只提交自己有使用权限的平台:
bash submit.sh p100
# 或选择V100 16G
bash submit.sh v100
squeue -u "$USER"
脚本提交一个Slurm作业,在所选GPU上依次运行八组输入;每组使用1张GPU、1个MPI进程、1个CPU线程。Submitted batch job ...给出的数字是Slurm作业号;提交脚本返回后,后续计算由Slurm管理。
作业完成后,P100结果按下面读取:
bash read.sh p100
bash plot.sh analysis-new-p100 figures-new-p100
cat analysis-new-p100/VALIDATION.json
V100结果则使用:
bash read.sh v100
bash plot.sh analysis-new-v100 figures-new-v100
读取新结果时只选择指定平台,不会将另一平台的旧输出混入新数据。若作业尚未完成,先查看p100/work-new/slurm-作业号.out或对应的V100文件。
3.软件环境与GPU调用方式#
两种GPU版本均为LAMMPS 30Sep2026,使用GCC 13.3、OpenMPI 5.0.10、CUDA 12.8、Kokkos 5.2.1双精度构建;P100与V100分别匹配各自架构。CPU参考由Intel oneAPI 2024.2构建版本生成,本次GPU对照直接读取这些既有参考。
提交脚本分别加载:
module load lammps/30Sep2026-p100-kokkos
# V100作业使用另一个模块,两个模块不要叠加加载
# module load lammps/30Sep2026-v100-kokkos
export OMP_NUM_THREADS=1
在已经分配到GPU的计算资源中,核心调用形式为:
lmp -k on g 1 -sf kk -pk kokkos newton on neigh half gpu/aware off -in in.lammps
完整提交脚本和逐组运行脚本均在包内,可直接使用bash submit.sh p100或bash submit.sh v100。保留显式的/kk样式便于判断本篇演示的是哪个实现;不要据此认为所有LAMMPS命令都自动在GPU上执行。
4.高斯网格:完整基础输入#
p100/inputs/gaussian/base/in.lammps与V100相同:
units lj
atom_style atomic
boundary p p p
region BOX block 0 8 0 6 0 4 units box
create_box 2 BOX
mass * 1
create_atoms 1 single 0.25 0.5 0.75 units box
create_atoms 1 single 3.25 2.5 1.75 units box
create_atoms 2 single 7.5 4.5 2.25 units box
create_atoms 2 single 5.5 1.5 3.5 units box
pair_style zero 1.8
pair_coeff * *
neighbor 0.2 bin
group TYPE1 type 1
compute G all gaussian/grid/local/kk grid 8 6 4 1.0 0.8 0.8 0.35 0.55
compute H TYPE1 gaussian/grid/local/kk grid 8 6 4 1.0 0.8 0.8 0.35 0.55
dump GRID all local 1 grid.dump c_G[*] c_H[*]
dump_modify GRID format float %.17g
dump AT all custom 1 atoms.dump id type x y z
dump_modify AT sort id format float %.17g
thermo 1
thermo_style custom step atoms pe
thermo_modify norm no format float %.17g
run 0
模型是8×6×4周期盒中的四个原子、两种类型,使用LJ约化单位。pair_style zero只提供邻居列表,不引入真实材料势。
grid 8 6 4给出三个方向的网格数;最后的0.35 0.55分别是两个类型的高斯宽度。这里的空间截断参数对应实际截断半径1.6,邻居与通信范围应覆盖它。包中保留了本版本完整命令与参数,不要仅把pair_style zero的半径照搬到任意模型。
compute G对全部原子统计,compute H只对TYPE1组统计,但二者仍在同一整盒网格上输出。dump GRID保存网格坐标和分类型描述符。这里是原子位置构造出的高斯场,不是DFT电子密度。
每个平台均运行以下四组:
| 组 | 网格 | 两种高斯宽度 | 观察内容 |
|---|---|---|---|
| base | 8×6×4 | 0.35、0.55 | 基础分类型网格 |
| wider | 8×6×4 | 0.70、1.10 | 展宽后峰形改变 |
| fine | 16×12×8 | 0.35、0.55 | 更细空间采样,共1536点 |
| translated | 8×6×4 | 0.35、0.55 | 整体沿x平移一个原网格间距 |
整数网格平移对应周期网格数据的重排,不能要求固定坐标处每个值仍不变。有限截断和有限网格下,离散积分也未必恰好等于原子数。
5.局部组成与邻域统计:完整基础输入#
p100/inputs/local/base/in.lammps:
units lj
atom_style atomic
boundary p p p
lattice sc 1.0 origin .5 .5 .5
region BOX block 0 8 0 4 0 4 units box
create_box 2 BOX
create_atoms 1 box
mass 1 1.0
mass 2 2.0
region RIGHT block 4 8 INF INF INF INF units box
set region RIGHT type 2
group TYPE1 type 1
variable VX atom 0.15*sin(2*PI*x/8)+0
variable VY atom 0.1*cos(2*PI*y/4)+0
variable VZ atom 0.05*sin(2*PI*z/4)+0
velocity all set v_VX v_VY v_VZ units box
pair_style zero 1.0
pair_coeff * *
neighbor .3 bin
comm_modify cutoff 1.4000000000000001
compute C all composition/atom/kk cutoff 1.1
compute CO all composition/atom/omp cutoff 1.1
compute A all ave/sphere/atom/kk cutoff 1.1
compute AO all ave/sphere/atom/omp cutoff 1.1
compute C1 TYPE1 composition/atom/kk cutoff 1.1
compute A1 TYPE1 ave/sphere/atom/kk cutoff 1.1
dump AT all custom 1 atoms.dump id type x y z vx vy vz c_C[*] c_CO[*] c_A[*] c_AO[*] c_C1[*] c_A1[*]
dump_modify AT sort id format float %.17g
thermo 1
thermo_style custom step atoms
run 0
128个粒子排成规则结构,左右两侧分别使用两种类型。指定的正弦速度模式用于演示局部平均量;这不是热化后的流体。
composition/atom/kk输出邻域分类型组成;ave/sphere/atom/kk输出球形邻域的平均量。按原子数定义的组成与质量加权的统计要分开理解,换质量后不能把二者当成同一种浓度。
同一输入中还保留/omp输出作数值对照,它们使用CPU实现,不能记成GPU加速功能。TYPE1组的输出还用于观察选组如何影响邻域统计。
| 组 | 邻域半径 | 质量与速度变化 | 用途 |
|---|---|---|---|
| base | 1.1 | 质量1、2,基础速度 | 基础局部组成与平均量 |
| boosted | 1.1 | 所有速度加(0.8, −0.2, 0.1) | 检查平均速度平移与去均速统计 |
| larger-neighborhood | 1.6 | 同基础组 | 观察邻域改变 |
| swapped-masses | 1.1 | 交换两种类型质量 | 区分原子数与质量加权量 |
修改邻域半径时同时检查通信范围。原子位置相同并不表示换质量后所有局部统计都相同。
6.实际数值对照#
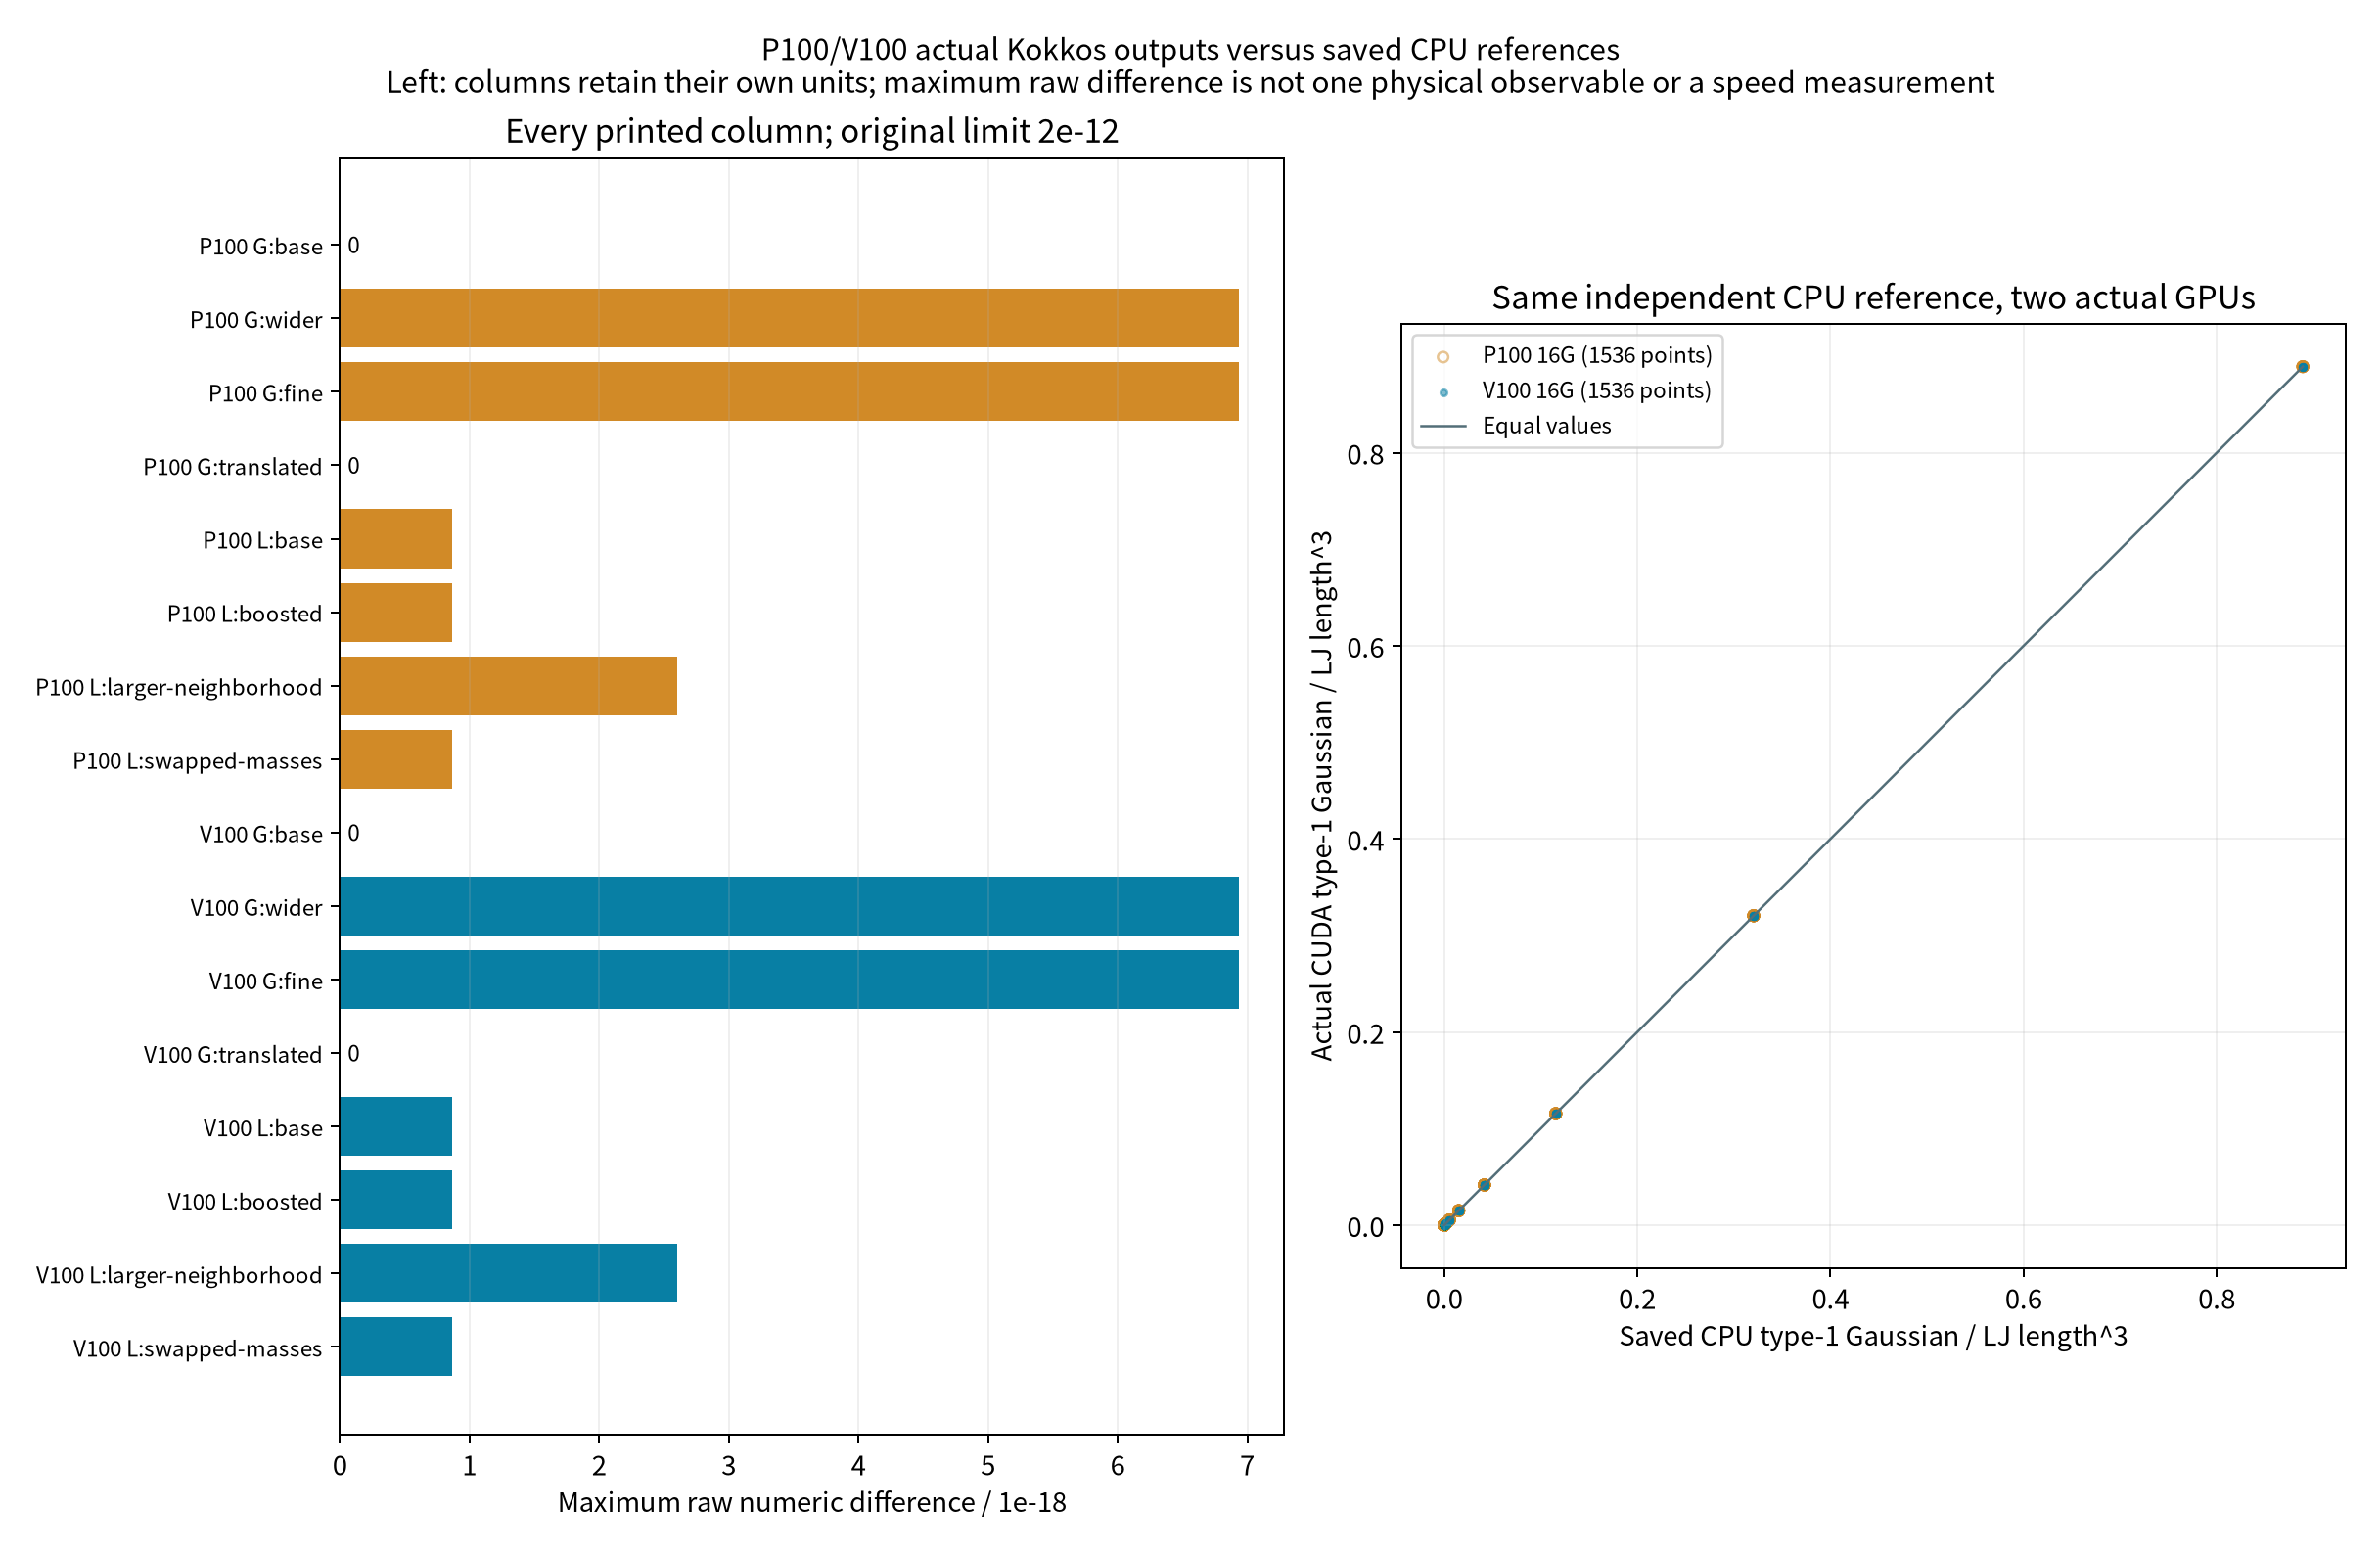
两种GPU各完成四组高斯网格与四组局部统计,均为实际Kokkos/CUDA输出。对照采用同一套独立高斯与邻域公式,以及相同输入的既有CPU原生数据。
| 条件 | P100最大原始数值差 | V100最大原始数值差 |
|---|---|---|
| Gaussian base | 0 | 0 |
| Gaussian wider | 6.94×10⁻¹⁸ | 6.94×10⁻¹⁸ |
| Gaussian fine | 6.94×10⁻¹⁸ | 6.94×10⁻¹⁸ |
| Gaussian translated | 0 | 0 |
| local base | 8.67×10⁻¹⁹ | 8.67×10⁻¹⁹ |
| local boosted | 8.67×10⁻¹⁹ | 8.67×10⁻¹⁹ |
| local larger-neighborhood | 2.60×10⁻¹⁸ | 2.60×10⁻¹⁸ |
| local swapped-masses | 8.67×10⁻¹⁹ | 8.67×10⁻¹⁹ |
各列保留自己的单位,上表汇总的是逐列原始数值差,不能把它解释成单一物理量误差或材料预测精度。使用的CPU/GPU绝对数值阈值为2×10⁻¹²;本例未测运行速度或多卡扩展。
7.如何用于自己的结构#
先在实例输入里替换盒子、原子位置与类型,再确认LJ约化单位是否符合目标模型;若改用真实材料势与其他单位制,需要重新确定参数。根据结构尺度选择高斯宽度、网格间距或邻域半径,并检查周期边界和通信范围。
先用run 0检查输出列与结构切片,再把需要的compute和dump接入自己的轨迹计算。加入积分器与实际势之后,运行开销和科学含义都会变化,应另外验证。
CPU版概念可结合分类型高斯网格和局部组成与邻域统计阅读;完整原生数据、提取脚本、两种GPU提交脚本与图片均在本篇实例包中。